@Rebecca Bellan / 27日前 マムダーニ、連邦政府はAIについて放棄したと語り、ニューヨーカーに反対を呼びかけ ニューヨーク市長マムダーニが連邦政府のAI規制放棄を批判し、市民に反対を呼びかけたAIの学校での導入と不動産広告のAI画像使用を禁止し、連邦政府の規制放棄を指摘AIの導入には市民の関与が不可欠で、連邦政府の対応が遅れていることが明確になった #AIエージェント#機械学習#キャリア
@a2 / 27日前 AIとコンテストに参加する AHC GenAI Rules Trial Contest 2026で生成AI利用ルールを試験的に適用したAGENTS.mdにルールを記載し、Codexに指示を明確に与えることで実装を補助する。配達順を焼きなまし法やy+xの基準で最適化する配達済みのマスを通過コストの高いマスに変更することで、すべての荷物を配達できる順序を確保する必要がある #AIエージェント#機械学習#DevOps・CI/CD
@Rebecca Bellan / 27日前 Laplace Intelligenceがロボットや自律走行車の実世界導入前に赤チームによるテストを実施 Laplace Intelligenceはロボットや自律走行車の実世界導入前にAIによる赤チームテストを実施している高精度シミュレーション環境とAIエージェントによる境界ケースの自動設計、NvidiaのCosmosを基盤としたシミュレーション実世界でのロボット導入に際して境界ケースの予測が難しいため、シミュレーションでのテストが不可欠である #AIエージェント#機械学習#インフラ
@rana_kualu / 27日前 【JavaScript】JSでようやくバッファ境界正規表現\A\zが使えるようになる JavaScriptに正規表現のバッファ境界\A\zが実装される\Aは文字列先頭、\zは文字列末尾を表し、mフラグの影響を受けないuまたはvフラグが必要で、文字クラス内では使えない #AIエージェント#機械学習#フロントエンド
@kimuchi_a / 27日前 AIは言葉も料理も理解していない? - 近年の画像生成AI - AIは料理の構造や言葉の意味を理解していない物理的矛盾や抽象的な感情の誤解、データ偏重によるハルシネーションが生じるAI生成画像の法的リスクや倫理的問題は使う側の管理に依存する #生成AI・LLM#AIエージェント#機械学習
@songchong / 28日前 重要な指示は最初か最後か? AI 大手 3 社の助言が異なるので、資料→命令→指示の並び方を 8 通り試してみた 指示は資料の中に書かないほうが良い。資料の途中に書いた指示は、4 つの条件の合計 36 回中 28 回従わない資料の途中に指示を書くと、75% の位置ではどの条件でも従わない。ツールの説明や CLAUDE.md が前に入る条件では並べ方の差は 0.5 点未満指示は資料の外に書く。資料を最後に置くと点数が高くなる。ツールありの条件では並べ方の差がほぼない #生成AI・LLM#AIエージェント#機械学習
@はせ / 28日前 判断特化モデルの比較: Decisions API・Jev・Clef Decisions APIとJevの判断特化モデルの比較結果を公開したDecisions APIは236.2msの中央値応答時間、Jevは181.5msで費用はJevが0.03537ドル/1000件応答時間の中央値と費用を重視する場合はJevが有利で、画像入力にはDecisions APIやClef系が対応 #AIエージェント#機械学習#DevOps・CI/CD
@kai-yo / 28日前 音声言語モデルが欲しくて 27B ver 27Bモデルは音声タスクでの学習なしにASR性能が向上、9Bモデルより精度が悪化ASRタスクでの学習なしにASR性能が向上、9Bモデルより精度が悪化、4bit量子化と文長制限でVRAM24GBで学習可能27Bモデルは音声と言語の一致が見られ、より精度を求めるには追加学習が必要 #生成AI・LLM#AIエージェント#機械学習
@charge0315 / 29日前 件数が少ないうちは眠る安全装置が、32日目に目を覚ました 〜Claude Codeと作った「実測勝率ゲート」と、ラベルと実装の食い違い〜 実測勝率ゲートが32日後に初めて動作し、短期候補をすべて停止した実測勝率が45%未満かつ約定件数20件以上で除外、記録が20件に達した10月13日に動作安全装置の動作条件を明確に記録し、ラベルと実装の整合性を定期的に確認する #AIエージェント#機械学習#テスト
@Anthony Ha / 29日前 Meta、スクラビングとAIトレーニングに関する言葉を削除 MetaがスクラビングとAIトレーニングに関する記述を削除した商業利用規約から「ウェブページやURLのコンテンツをAIモデルにトレーニングに使用できる」という記述が削除され、広告とビジネス製品に限定されたMetaのウェブクローラーの利用方法に変更はなく、スクラビングの範囲が限定された #生成AI・LLM#AIエージェント#機械学習
@nooop / 29日前 Jetson AGX XavierでNemotron 3.5 Lightningを動かしてみる Jetson AGX XavierでNemotron 3.5 Lightningを動かして24〜34 tokens/secで動作確認A3B量子化モデルとMTPの有無で速度が変化、並列処理で1.6倍向上MTPありは1リクエストで速く、MTPなしは並列処理でより効率的でメモリ使用量が少ない #生成AI・LLM#AIエージェント#機械学習
@YuukiYoshida / 29日前 Gemini 4 Argonの100万トークンは何がすごい?仕様・料金・制限を公式情報から整理してみた Gemini 4 Argonは100万トークンのコンテキストを共有し、Long decodeで65,536トークンを超える出力を可能にした入力・思考・出力のトークンが1,048,576で共有され、Long decodeはバックグラウンド実行で最大1,048,576トークンまで生成可能Long decodeを使うと処理時間が数分かかり、料金は12月1日から2倍になるため、処理内容とコストを事前に確認する #生成AI・LLM#AIエージェント#機械学習
@Russell Brandom / 30日前 JevはVercelで最も早く採用されたAIモデル JevがVercelで最も早く採用されたAIモデルになったJevは2週間で35%の有料チームが利用し、Sonnet 5.5の2倍の影響力を持ったJevは処理速度とコストが優れており、大規模なデータ分類に適している #生成AI・LLM#AIエージェント#機械学習
@viewlagoon / 30日前 Codingame Summer Challenge 2026 で24位になりContests部門Top10入りしました Codingame Summer Challenge 2026で24位を取得しContests部門Top10に入った強化学習で学習したU-NetモデルをC++で推論し、量子化認識学習でモデルサイズを圧縮した提出コードとニューラルネットワーク重みを合わせて100,000文字以内に収める制約があり、モデルサイズとパラメータ数のバランスが重要だった #AIエージェント#機械学習#DevOps・CI/CD
@shinkai_ / 30日前 エンジニアに情報漏えいは防げないのか? ハッシュ化のコスト設計で「盗まれたあと」は変えられる パスワードのハッシュ化で計算コストを高めることで、情報漏えい後の被害を抑えるbcryptのcost factorやArgon2のメモリ・反復回数、scryptのN・r・pで調整するOWASPの最低ラインを確認し、ログイン時の待ち時間とサーバー負荷のバランスを取る #機械学習#セキュリティ#バックエンド
@nishina / 31日前 ベクトルDBを使わない「階層ナビゲーション型RAG」を作って、ベクトルDB版RAGと比較してみた 階層ナビゲーション型RAGはベクトルDBを使わず、LLMで階層を辿って文書を選ぶ手法で、ベクトルDB版RAGと同等の正答率を達成した階層ナビゲーション型は要約カードとk-meansクラスタリングで階層を作り、LLMで降りる。ベクトルDB版は埋め込みと類似度検索で文書を選ぶ階層ナビゲーション型はLLM呼び出し回数とレイテンシが高かったが、正答率は同等で範囲外質問では文書を取得しないことでコストを抑えた #生成AI・LLM#RAG#機械学習
@T. Shimotomai, PhD. / 31日前 VLAのベンチマークまとめ:標準シミュレーションから頑健性・記憶・安全・実機・産業まで VLAモデルの評価ベンチマークが標準タスクから頑健性・記憶・安全・実機・産業まで広がっているLIBERO、LIBERO-Plus、LIBERO-Para、HazardArena、Industrial Dexterity Benchmark、RoboCasaが主なベンチマークで、それぞれ異なる評価軸を持つ標準ベンチマークの成功率だけではモデルの実力を判断できないため、頑健性や言語感度などの異なる評価軸を組み合わせて比較する必要がある #AIエージェント#機械学習#バックエンド
@m_izumo / 31日前 Opus 5.5 の effort high と xhigh のレビュー性能とダブルチェックの効き目を、15 区分・45 本で測った Opus 5.5 の effort high と xhigh のレビュー性能に差があり、xhigh は重い不具合の検出率が高かったhigh が 55% の網羅率、xhigh が 67%、高重要度の検出率は high 52% と xhigh 85%、xhigh 2 本で網羅率 85% にxhigh 1 本は高重要度の不具合を 85% 検出できるが、コストは high の 1.3 倍で、重い不具合は xhigh 2 本で確保するべき #AIエージェント#機械学習#DevOps・CI/CD
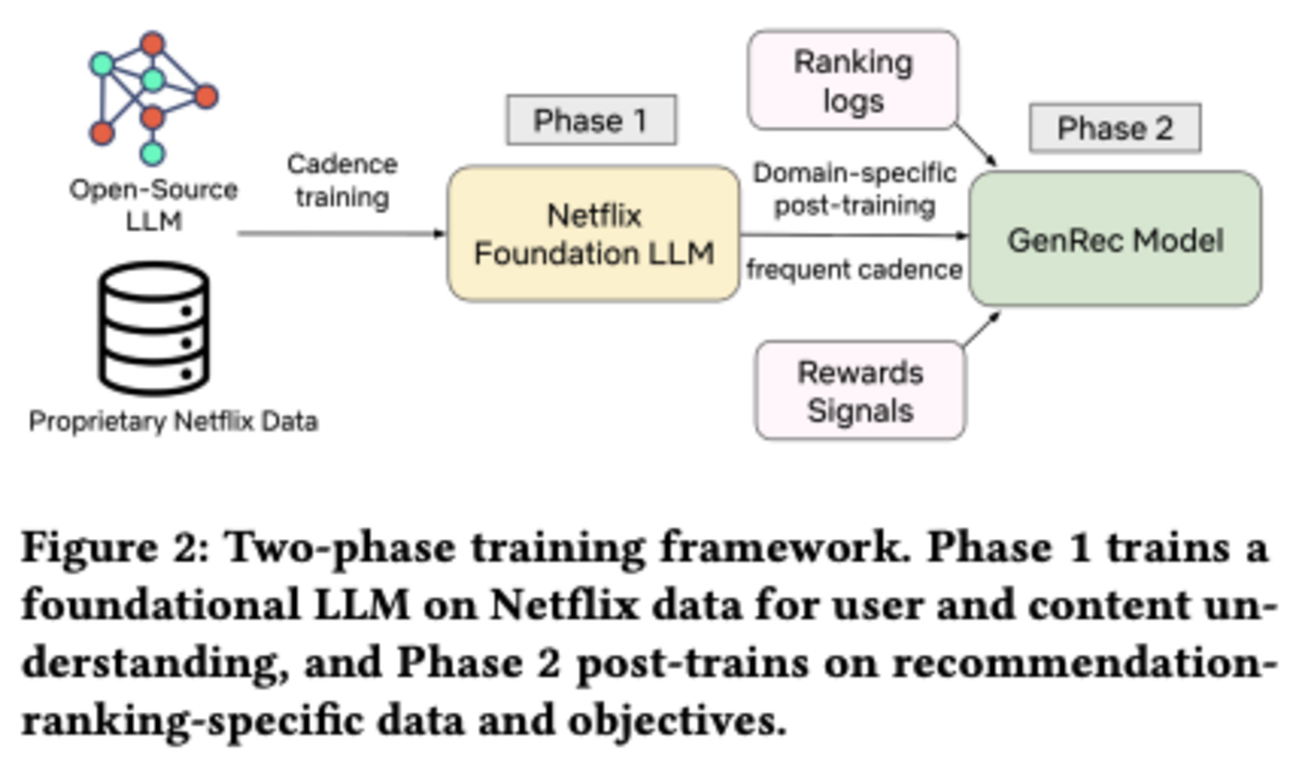
@Stockmark Tech Blog / 31日前 論文解説:GenRec: An LLM-Backed Recommendation Ranker at Netflix NetflixがLLMを活用した推薦ランキングシステムGenRecを導入Phase1でOSS LLMをカスタマイズ、Phase2で推薦タスク向けに微調整、長期的な満足度を報酬に最適化ユーザー履歴を自然言語で入力し、推論コストを抑えるためのコンテキスト長の最適化が重要 #生成AI・LLM#AIエージェント#機械学習
@Aisha Malik / 32日前 Ricursive IntelligenceはAIで設計されたチップで計算の危機を解決する試み Ricursive IntelligenceはAIでチップを設計する技術を開発し、計算需要の増加に対応するAIがチップのレイアウトを最適化し、従来の分割設計ではなく全体を最適化する手法を採用チップ設計にかかる時間が短縮され、カスタムチップの製造が可能になるが、製造コストとエネルギー効率のバランスが重要 #生成AI・LLM#AIエージェント#機械学習

 最終更新 2026/11/16 12:01