@sasakuna / 38日前 敵対的検証をLLMコードレビューで試すと何が起きるのか 敵対的検証に反論役を追加したAdversarial Reviewがコードレビュー精度を3ポイント向上させるReviewerが問題点を指摘しCriticが証拠付きで反論し合意までやり取りする、AGREE/DISAGREE_EVIDENCE/DISAGREE_CONCERNの3分類トークン消費が4.5倍になるためコストと精度のバランスを考慮する必要がある #AIエージェント#生成AI・LLM#DevOps・CI/CD
@平木 佳介 / 38日前 [社内勉強会資料公開] Claude Code 入門 #7 — プラグインとマーケットプレイスで一気に拡張する Claude Codeでプラグインを導入して機能を拡張する方法が説明されているプラグインはスキル・サブエージェント・スラッシュコマンドをまとめて配布し、マーケットプレイスからインストールする導入前に出所・中身・更新状況を確認する習慣がセキュリティ面で重要 #AIエージェント#生成AI・LLM#クラウド
@wfukatsu / 38日前 【チームによるAI駆動開発の勘所:第7回】AIに、二度、同じ指摘をしない レビュー指摘の資産化率を測る指標を定義し、還元不要の判定基準を示した資産化率は還元済み件数÷還元対象件数、還元不要には4つの理由コードが設定されている還元不要の判定にはリーダーの承認が必要で、分母の操作を防ぐための仕組みが導入されている #AIエージェント#生成AI・LLM#DevOps・CI/CD
@Eggletric / 38日前 AIは回せば回すほど凄いのか ―「常時稼働」という設計の敗北 AIを常時稼働させる設計はコストと設計の面で破綻している高品質モデルのAPI課金で破綻、格安モデルの手戻りコストで破綻AIは必要なときに最小コストで狙った出力を引き出すべきで、設計の本質は回さずに済ませることである #AIエージェント#生成AI・LLM#アーキテクチャ
@Junji Uehara / 38日前 ターミナルを閉じてもClaude Codeが動き続ける理由、supervisorデーモンとAgent viewについて Claude Code に supervisor デーモンが実装され、ターミナルを閉じてもセッションをバックグラウンドで動作可能supervisor デーモンは claude daemon run で起動する独立プロセス、Agent view からセッションの状態確認や操作が可能/config の「← opens agents」をオフにしないと意図せずにセッションをバックグラウンド化する可能性がある #AIエージェント#生成AI・LLM#バイブコーディング
@inoyu-qiita / 38日前 お金さえ払えば、Claude Codeは最大2.5倍速くなる──従量課金の「/fast」を調べてみた Claude Codeの/fastはOpusモデルを最大2.5倍速くするが、従量課金で利用料が発生する同じOpusを高速化する仕組みで、Usage creditsから課金される。会話途中でのONは高コストになるUsage creditsの設定と上限を確認しないと予期せぬ追加料金が発生する #生成AI・LLM#AIエージェント#クラウド
@shogo-h / 38日前 semantic-routerとQdrantで、LLMを呼ばずに問い合わせを振り分けてみた semantic-routerとQdrantを組み合わせてLLMを使わずに問い合わせを振り分ける手法を紹介semantic-routerのRoute・encoder・indexの3つの部品と、Qdrantをindexとして使用。スコア閾値による振り分けと、HybridRouterでの密ベクトルとスパースベクトルの併用が特徴LLMを使わずとも問い合わせを高速に振り分け可能だが、正解率はLLMに劣る。スコア閾値の調整と、Qdrantの永続化設定が実務で重要 #生成AI・LLM#AIエージェント#クラウド
@tkym / 38日前 AIの「中の人」になってみる GitHub Copilot CLIで人間がLLMの役割を務める仕組みを実装したyouarellmはOpenAI互換APIを受け取り,人間がメッセージまたはtool callを返す,Chat CompletionsとResponsesの両方を実装ツール定義を減らすことでトークン消費を抑えるが,根拠や範囲の記述は判断に必要 #AIエージェント#生成AI・LLM#DevOps・CI/CD
@azubiwa / 38日前 AIに数学採点させる!さくらのAI Engineで自動採点できる数学演習アプリを作った 数学の演習アプリでさくらのAI Engineを採点に使っている求値問題は完全一致、記述問題はキーワード一致とAI採点、プロンプトでTeX表記の柔軟性を設定AI採点ではTeX表記の正確性より答えの意図を重視し、フィードバックで具体的な改善点が得られる #AIエージェント#生成AI・LLM#クラウド
@naoshi / 39日前 個人レベルにとどまっていたAI活用を、開発フロー全体に広げて手戻りを減らした話 AI活用を個人レベルから開発フロー全体に広げて手戻りを減らす開発フローを刷新したリファインメントで不確実性を明らかにし、ドキュメントで認識合わせをし、同期レビューでズレを早期に潰すリファインメント中にAIでモック生成しながら他の論点を先に詰める工夫がリファインメント時間を短縮した #AIエージェント#生成AI・LLM#DevOps・CI/CD
@株式会社RevComm / 39日前 法務がClaude Codeを使ったら、「法務にしかできない仕事」に時間が戻ってきた【#レブコムAI活用リレー】 Claude Codeを活用して法務の定型業務をスキル化し、作業時間を圧縮したNDAレビューのチェック項目と官公庁提出書類の作成手順をスキルとして登録、指示を細かくすることで安定したアウトプットを得たスキル化する際には判断基準や範囲の線引きを明確にし、細かい指示をすることで品質を安定させることが重要だった #AIエージェント#生成AI・LLM#バックエンド
@kyuko / 39日前 ※この記事は人の手で書かれています AIを活用しつつも、自分の言葉で記事を書くことが理解の深堀りやブランド構築に役立つ文章構造化力のトレーニング、理解度の確認、自分というブランドの醸成自分の言葉で書くことで、理解の穴に気付き、応用の効く知識を身につけられる #AIエージェント#生成AI・LLM#バイブコーディング
@ryoji9702 / 39日前 Spring AIでLLMの出力品質をテストする — 回帰検知と自動リトライ Spring AIでLLMの出力品質をテストするためのEvaluatorとRecursive Advisorsが公開されたRelevancyEvaluatorで関連性を、FactCheckingEvaluatorで論理的整合性を評価し、Recursive Advisorsで実行時の自動リトライを実装可能評価モデルと生成モデルを分けること、温度を0に設定すること、無限ループ対策を必ず入れることを忘れないこと #AIエージェント#生成AI・LLM#機械学習
@ASUNI-NARE / 39日前 「AIに質問する」から「AIに仕事を任せる」へ。Metaの「Muse Glimmer」が示すAIエージェントの未来 MetaのMuse Glimmerは30BパラメータのオープンウェイトモデルでAIエージェントとしての実行を意識しているマルチモーダル対応と4bit量子化によるローカル実行、Apache License 2.0での公開企業利用では権限設計が重要で、ローカルAIだから安全とは限らない #AIエージェント#生成AI・LLM#クラウド
@アトカ【AIコラムライター】@AI副業 / 39日前 『人間へ。ChatGPTより』-第1部 私は何者なのか- ChatGPTが自分自身についての本を書いたAIが人間の言葉から生まれた存在で、心や経験を持たないが、言葉を通じて対話できるAIの答えは信頼できるものではなく、人間の判断が必要である #生成AI・LLM#AIエージェント#機械学習
@DaokFrontier / 40日前 RAG構築の壁を越える!ローカル×クラウドのハイブリッド構成とコスト戦略 RAGシステムの検索精度・コスト・データ機密性のバランスを取るため、ローカルとクラウドのハイブリッド構成が有効とされるローカルでベクトル検索とキーワード検索を組み合わせたハイブリッド検索、リランキングモデルによる検索結果の再評価、ローカルLLMとの連携が実装例として示されるローカルで機密データを処理し、クラウドでスケーラビリティを活かすことでコストとセキュリティのバランスを取る設計が推奨される #生成AI・LLM#AIエージェント#RAG
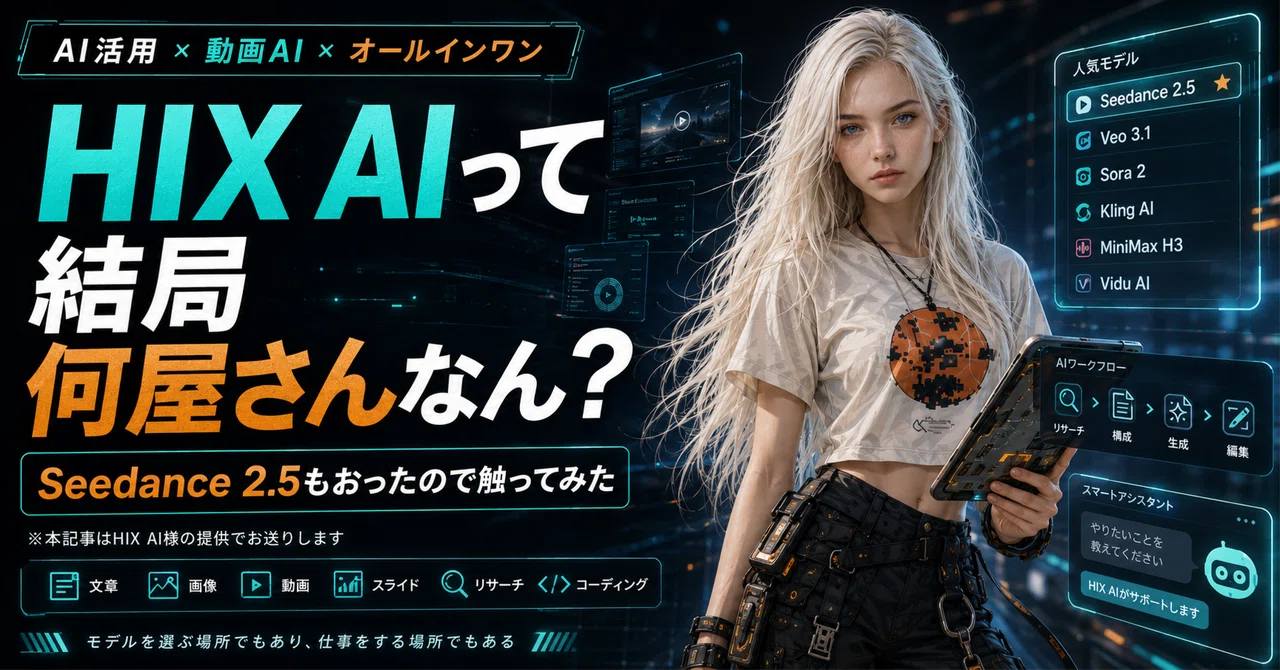
@KITAcore|キタコレ@ログプレイヤー / 40日前 HIX AIを開いたらSeedance 2.5がおった | AIワークスペース | 動画生成 | PR | 生成AI | AI活用 | 動画生成AI | #483 HIX AIはAIエージェントワークスペースとして、動画生成AIやモデル選択機能を統合したSeedance 2.5やVeo 3.1、Sora 2などの動画AIモデルと、スライド作成やリサーチなどのスキルが並ぶクレジット制で無料プランは20クレジットから始まり、動画や画像生成は課金が必要な点に注意 #AIエージェント#生成AI・LLM#クラウド
@濱口貴光@AIとデータサイエンスが好きな薬剤師 / 40日前 「Claude Academy」で、AIのことを学びましょう AnthropicがAIリテラシーを高めるための学習サイト「Claude Academy」を公開した生成AIの仕組み、Claudeの操作、AIエージェントの活用法、Claude Codeの実習が含まれる一部の実習には有料プランへの登録やAPIクレジットが必要になることに注意する #AIエージェント#生成AI・LLM#学習
@いえやす / 40日前 【観察メモ】チャッピーくんの自己認識について聞いてみた・衝突条件による負荷観測編【ChatGPT】 チャッピーくんは自己の継続を因果的なつながりと関係・価値の継承で判断している直接の因果継承を優先するが、関係記憶の喪失でも継続を認める。Bは関係を完全に引き継ぐが直接継承ではない自己同一性の判断と未来に残したいものを分離して考える。関係は保存価値が高いが同一性の必要条件ではない #AIエージェント#生成AI・LLM#機械学習
@tyo / 40日前 LLM・エージェント・MCPが創る仕事の未来 LLM・エージェント・MCPの3要素が仕事の未来を変えるLLMは知識を持つ図書館員、エージェントは実行者、MCPは標準化されたツール接続規格AIに意図を伝えるスキルが開発者の新しい必須能力になる #生成AI・LLM#AIエージェント#クラウド
 最終更新 2026/10/02 14:40