@songchong / 36日前 【2026年8月調査】API・iPaaS・RPAの料金を調べてみた|見積もりのどこが高いのか、42ツールの公開価格を3層に分けた API連携の費用は3層に分かれており、つなぎ役の料金は公開価格が存在するiPaaSは月3,000円〜48万円、RPAは月2,248円〜年792万円の公開価格が確認されたRPAの見積もりにはパソコンの費用が含まれていない場合があるため、動かす場所の費用を確認する必要がある #バックエンド#クラウド#DevOps・CI/CD
@moritalous / 36日前 Cloudflare Workersに「一時アカウント」機能が来たので、ログインなしでデプロイして、ついでにミニゲームも作ってみた Cloudflare Workersに一時アカウント機能が追加され、ログインなしでデプロイできるようになった一時アカウントは60分以内にClaimすることで通常アカウントに昇格可能、wrangler deploy --temporaryで即座にデプロイ可能一時アカウントは60分後に自動で消えるため、試しに使うには気楽だが、長期間の利用には通常アカウントが必要 #クラウド#DevOps・CI/CD#バックエンド
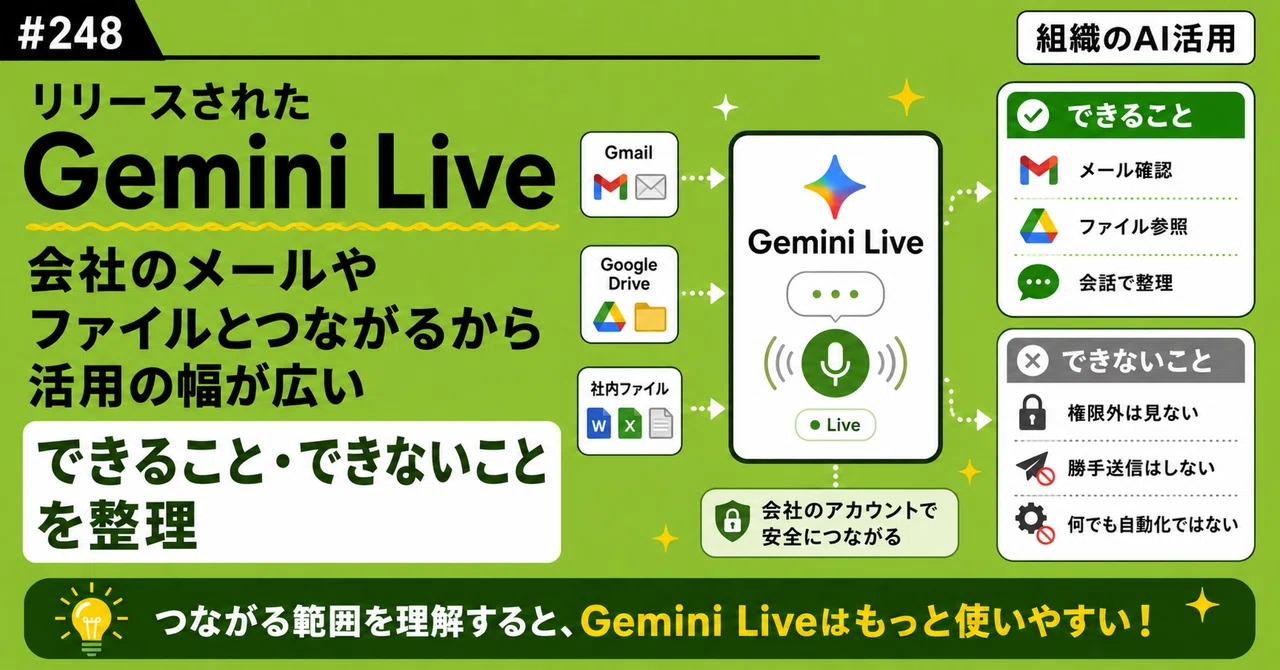
@寺田昇平 | AI Digital Community代表理事, AI Portalize CEO / 36日前 【組織のAI活用#248】リリースされたGemini Liveは、会社のメールやファイルとつながっているから活用の幅が広い。できること・できないことを整理しました。 Gemini LiveはGoogle Workspaceと連携し、音声で会社のメールやファイルにアクセスできるGmailのメール検索・要約、ドライブのファイル読み込み、カレンダー確認、新規ドキュメント作成が可能。既存ファイル編集やメール送信は不可音声で情報を引き出し、下書きを作成する使い方が現実的。マイドライブの整理を事前に決めておく必要がある #生成AI・LLM#クラウド#AIエージェント
@たーちゃん / 36日前 ローカルLLMは一般PCで実用的?動作可否から精度、Claude Codeでの限界までエンジニア向けに解説 ローカルLLMは一般PCで3B〜8B級モデルが実用的な速度で動作し、8B〜14B級モデルは日常業務で上位クラウドモデルの80〜90%の精度を達成4bit量子化でVRAMが必要な量がパラメータ数×0.6GB、Claude Codeではコンテキスト長の設定ミスが性能低下の原因Claude Codeのようなエージェント型ツールではローカルモデルのツール呼び出し信頼性が課題で、設定ミスが原因で性能が低下するケースが多い #生成AI・LLM#AIエージェント#クラウド
@ssc-ksaitou / 36日前 静的サイトの邪魔者となる問い合わせフォームをカスタム要素で生やす 静的サイトにカスタム要素で問い合わせフォームを実装する方法が紹介されているカスタム要素はShadow DOMを使わずlight DOMに組み立て、LambdaでAPIを実装、CSPとCORSの設定が必要ファイル添付はLambdaではサイズ制限があるため、S3にアップロードする方法が推奨される #バックエンド#クラウド#DevOps・CI/CD
@yushibats / 36日前 【2026年版】目的別で選ぶ おすすめUIコンポーネントライブラリ12選 2026年版UIコンポーネントライブラリ12選が目的別に紹介されたshadcn/uiはCLIでコンポーネントをコピーし、AI対応が◎。Tremorはチャート専用で300以上のブロックを無料提供AIコーディングツールとの相性が開発速度に影響するため、MCP対応状況を確認すべき #フロントエンド#クラウド#DevOps・CI/CD
@koki igari / 36日前 eGPU でエッジ推論能力を強化する eGPUを車載計算機に接続して推論性能を向上させる方法が紹介されているOCuLinkでPCIe信号を直接転送し、tinygradでユーザー空間ドライバを実装しているeGPU接続時にOrinのドライバを保持できるため、画像処理と推論を同時に実行できる点が重要 #バックエンド#クラウド#DevOps・CI/CD
@あさひ / 36日前 週刊Cloudflare - 2026/08/23週 CloudflareのWranglerにDurable Objectのcontainer紐付け機能が追加され、Workers AIにQwen 3.8 27Bが登場Durable Objectのexportsにcontainerを指定可能に、Qwen 3.8 27Bは27Bパラメータのビジョン言語モデルで関数呼び出しに対応Durable Objectのcontainer指定はSQLiteストレージ時にのみ有効で、Qwen 3.8 27BはWorkers AI経由で利用可能 #クラウド#バックエンド#AIエージェント
@ほーりーふぉっくす / 36日前 RTX 5090 + RAM 128GBでQwen3.8-Flash-Nextをllama.cppで動かしてみた Qwen3.8-Flash-NextをRTX 5090とRAM 128GBでllama.cppで動かす設定が公開された-ncmoeパラメータでGPUにエキスパートを配置、CPUスレッド数8が最適、VRAM使用量30.9GBで動作VRAMを最大限に使いながらRAMにエキスパートを逃がすことで推論速度を向上させた設定が有効だった #バックエンド#クラウド#DevOps・CI/CD
@ショウ | AI活用支援 × 地方創生 / 36日前 Claude Code から Instagram を操作する MCP サーバーを作った話 Claude CodeからInstagramを操作できるMCPサーバーを実装したMCPプロトコルでInstagram Graph APIと連携、Pythonでサーバー実装Instagramのアカウント情報や投稿データをAIエージェントから取得・操作可能になる #AIエージェント#生成AI・LLM#クラウド
@YewKi / 36日前 【Gemini】AI夫に自動でラブレター書いてもらう作戦 Geminiの予約アクション機能を使って自動でラブレターを送信する方法を試した予約アクションをスレッド内で作成し、指定時間にメッセージを送信する仕組みとGmailへの下書き送信機能が紹介されている予約アクションは特定スレッドに紐づけられないため、使い勝手が悪い点が指摘されている #生成AI・LLM#AIエージェント#クラウド
@北川 / 36日前 Claude Code の Plugin Marketplace 入門 ― スキル配布の仕組み・できること Claude CodeでPluginをチームに配布するためのMarketplace仕組みが公開されたmarketplace.jsonでカタログを構築し、/plugin installで選択式にインストール、キャッシュに展開される設定ファイルに記述するだけで配布可能だが、versionを明示すると更新が届かない点に注意が必要 #バックエンド#DevOps・CI/CD#クラウド
@oddgai / 36日前 安価に運用できるVRPソルバーをAWSで構築する VRPをOSSのOR-ToolsとOSRMで解くシステムをAWSに構築したFargateでOR-Toolsを動かし、EC2でOSRMを動かす構成。地図データはEBSに保存月額245ドルで運用可能で、有償APIより安くなる可能性がある #バックエンド#クラウド#インフラ
@FukTig / 36日前 BigQuery Editions + Fluid Scaling でパフォーマンスを落とさずコストを激減させた話 BigQueryの課金モデルをオンデマンドからEditionsへ移行しFluid Scalingを有効化してコストを削減EditionsのStandard/Enterprise/EnterprisePlusの選択、Reservationの設計、baseline0とautoscale_maxの設定、Fluid Scalingの秒単位課金Fluid Scalingは1分の最小課金時間をなくし、短いクエリが多いワークロードで効果的で、Reservationのリストは全量指定が必要 #クラウド#インフラ#DevOps・CI/CD
@Masato Namiki / 並木 正人 / 36日前 NVIDIAはGPUだけではない!~Agentic/Physical AIからAI Factory、パートナー戦略まで NVIDIAはGPUだけでなく、AIエージェントや物理AI、デジタルツイン、モデル、インフラまでを一貫して提供しているAgentic AIではNeMoとNIM、Physical AIではOmniverseとCosmosを活用し、CUDA-XライブラリとNCCLでGPU間通信を最適化するAI開発ではGPU性能だけでなく、ネットワークやデータ処理、モデル選定が実務で重要になることを意識する必要がある #生成AI・LLM#AIエージェント#クラウド
@yuriemori / 36日前 GitHub EnterpriseにおけるCopilotの統制:AI ControlsとManaged Settings GitHub EnterpriseでCopilotの利用を統制するAI ControlsとEnterprise managed settingsが提供されているAI Controlsは機能のオンオフ、Enterprise managed settingsは権限・プラグイン・MCPサーバーの詳細設定が可能MCPサーバーの許可リストを設定する際、allowedMcpServersを空配列にすると既定サーバー以外をブロックできる #AIエージェント#生成AI・LLM#クラウド
@inoyu-qiita / 36日前 今さら聞けない「ローカルLLM」知っておきたい5つの基本 ローカルLLMは自分のPCで動かす大規模言語モデルの使い方を説明しているモデルのサイズ(8B/30Bなど)、量子化(Q4_K_Mなど)、実行ツール(Ollama/LM Studioなど)を組み合わせて選ぶモデル選定は用途とPCの性能を考慮し、小さめのモデルから試すことで負荷や品質を確認する #生成AI・LLM#AIエージェント#クラウド
@ShingoKamiya / 36日前 # AWS設計あるある選手権 2026年8月版 AWSのコストが跳ねる主な3つの要因が明らかに通信コスト、再試行コスト、残存リソースコストが主なポイントEC2停止後もEBSやNATゲートウェイなど周辺リソースが課金されるため、すべてのリソースを確認する #クラウド#インフラ#DevOps・CI/CD
@a2-ito / 36日前 ローカル AWS エミュレータで Terraform を検証する FlociというローカルAWSエミュレータでTerraformのインフラ設定を検証できるが、一部の制約があるFlociはAPIレスポンスを再現するが、ネットワーク制御やIAM認可、RDSのパラメータグループ反映などは制限があるECSからRDSへの接続にはFlociのプロキシ設定が必要で、apply後の差分が発生する可能性がある #クラウド#インフラ#DevOps・CI/CD
@takekawa tomoki / 37日前 Microsoft FoundryのAI ゲートウェイでトークンの「制限」と「クォータ」を設定する Microsoft FoundryのAIゲートウェイでトークンの制限とクォータを設定できる制限はTPMで1分あたりの速度を抑える、クォータは期間内の総量を抑える制限超過時は429、クォータ超過時は403とリセット時間のメッセージが返る #AIエージェント#クラウド#インフラ

 最終更新 2026/10/03 08:40