@Nishio Hibiki / 10日前 【Nishika 論文サク読み 第27回】似た形の漢字を検索するモデル Vision Transformerを用いて漢字の見た目の類似度を測るモデルが公開されたHOMOGLYPHモデルはデジタルフォントの画像で対照学習し、コサイン類似度で類似度を計算。ホモグリフ編集距離で文字列マッチングを改善日本語の辞書は約150MBで、1文字あたり800文字との類似度が保存されている #生成AI・LLM#AIエージェント#機械学習
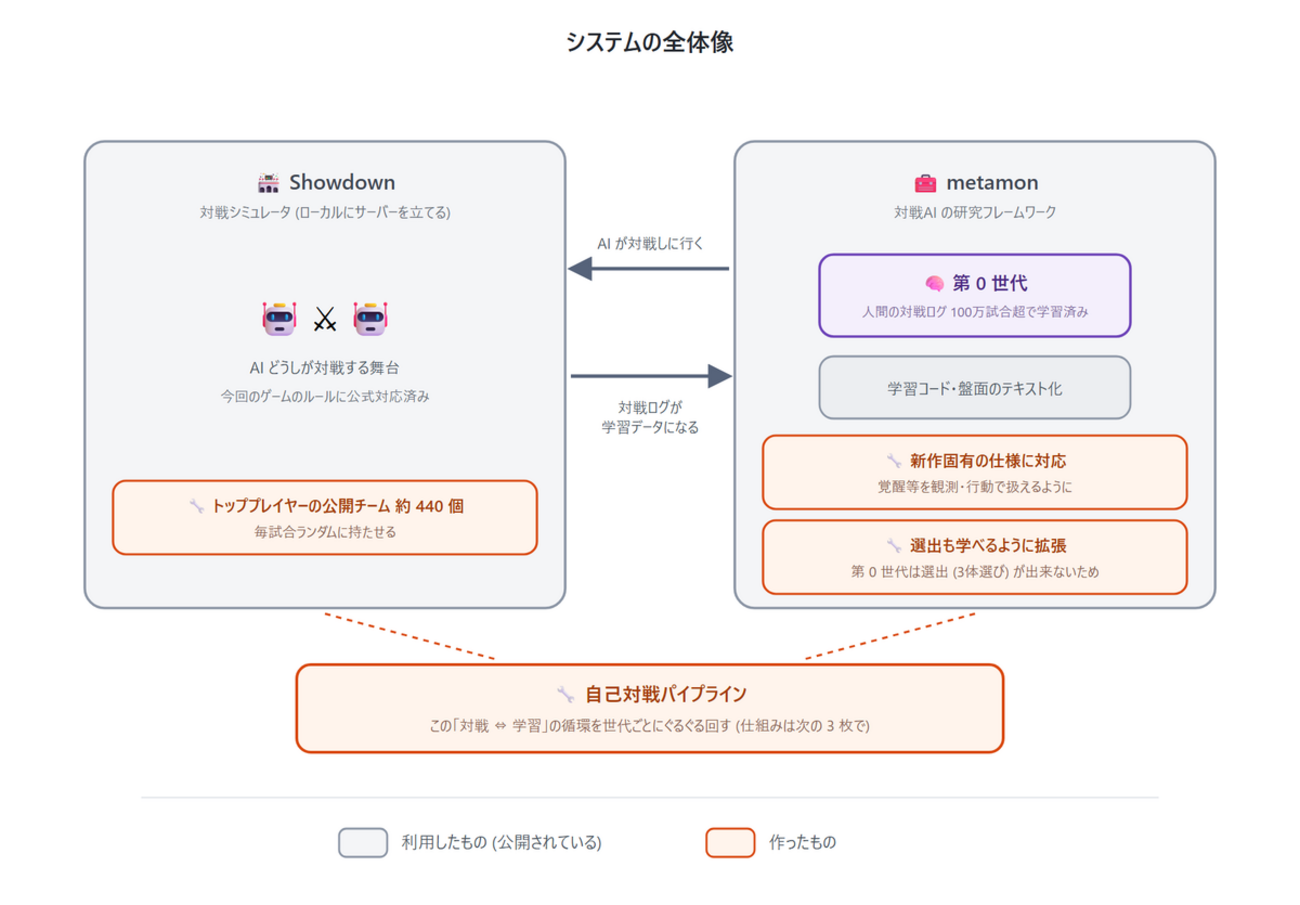
@Intelligent Technology's Technical Blog / 11日前 強化学習で対戦ゲームの AI を作って、戦ってみた 強化学習で対戦ゲームのAIを作り、自分と戦った結果を公開した自己対戦でデータ作成、報酬と模倣項で学習、選出に正則化を追加選出の読み合いはうまく学べず、覚醒の使い方だけは自力で身につけた #生成AI・LLM#機械学習#AIエージェント
@tomi / 11日前 娘とのクイズ遊びをアプリにしたら、日本語の奥深さを体感した話 クイズを「つくる」アプリを開発し、日本語の文のつなぎ方をルールとAIで対応したヒントの品詞種類9種類とつなぎ方のルール、AIによる単語の属性判定と文の組み立てAIに任せるのは単語の属性判定だけにし、文の組み立てはルールで行うことで待ち時間を削減した #フロントエンド#AIエージェント#機械学習
@Mikihiro Tanaka / 11日前 SigLIP2に匹敵する画像エンコーダーをフルスクラッチで開発した話 SigLIP2と同等の英語性能を維持しつつ、日本語・中国語ベンチマークで上回る画像エンコーダーをスクラッチで開発したViT-SO400M-14-SigLIP2構造を採用し、Interleavedデータの処理とRecaptionデータのフィルタリングを実施日本語・中国語のドキュメント理解タスクでSigLIP2を上回る結果を確認し、画像・テキストの対応付けが向上している #生成AI・LLM#機械学習#AIエージェント
@YUSUKE TABATA / 11日前 CEATEC 2026に見るPhysical AIの現在地 CEATEC 2026でPhysical AIの技術が現実世界での応用に進んでいることが確認されたヒューマノイドロボットやロボットアームがAIによる自律的動作を実現し、農業や店舗での作業支援が可能になったロボットの性能競争は単なる機械性能ではなく、AIによる状況理解力が鍵になる #AIエージェント#機械学習#インフラ
@からあげ / 12日前 NVIDIAの音声修復モデルRE-USEでポッドキャストのノイズ除去と文字起こしを比較してみた NVIDIAの音声修復モデルRE-USEでポッドキャストのノイズ除去と文字起こしの比較を行ったRE-USEは音声のノイズを減らすモデルで、Whisperは音声を文字に変換するモデル、CERで認識精度を測定した原音で文字起こしをしたほうが精度が高く、修復後の音声は配信用に使うのがおすすめ #AIエージェント#機械学習#バックエンド
@shalXXXX / 12日前 防御側の LLM 活用:ログ分析・アラート一次対応・脅威インテリジェンスで「ログを入力として疑う」設計 防御側のLLMでログ分析やアラート対応を行う際、ログに仕込まれた指示文がモデル出力を歪めるログの要約でIPやユーザー名が元データと異なる、アラートの無害判断で誤検出、IoC抽出で原文にない値を生成モデル出力と元ログを突き合わせて不一致を検出、自動判断は優先度上げる方向に限定する #AIエージェント#機械学習#セキュリティ
@Marina Temkin / 13日前 Trajectory、4500万ドルを調達し、非技術者向けにAIモデルトレーニングを可能に Trajectoryは4500万ドルを調達し、非技術者がAIモデルをトレーニングできるようにする継続的学習とオープンソースモデルの後処理を組み合わせ、専門分野での改善を自動化する専門家がモデルを自分で改善できるが、人間の関与が必要で自動的な自己改善は避ける #生成AI・LLM#AIエージェント#機械学習
@Julie Bort / 13日前 AnthropicがRSI能力に非常に近いと警告、つまり自己構築型AI Anthropicは自己改善型AI(RSI)の能力に非常に近いと警告したRSIはAIが自己訓練を効率化し、能力が急激に向上する段階で、Anthropicは現在のモデルがこの境界に近づいていると述べたAnthropicは今後も人間の監督を維持する方針で、モデルの進化が安全対策を追い越す可能性がある #生成AI・LLM#AIエージェント#機械学習
@eiji-noguchi / 13日前 Strataを使ってMac mini(32GB)でQwen3.8-Flash-Next(125B)を動かす Strataを使ってMac mini(32GB)でQwen3.8-Flash-Nextを動かす方法を紹介SSDから読み込みながら動かすMoEモデルと、ターミナルでの接続設定がポイント32GBのメモリでも100B超えのモデルが動くが、処理速度は遅い #生成AI・LLM#機械学習#クラウド
@Ram Iyer / 13日前 42AI、6250万ドルを調達し「人間の行動を予測する世界モデル」を公開 42AIが人間の行動を予測する世界モデルを公開し、6250万ドルの資金調達を実施した行動予測モデルは心理的傾向を数値化し、トランスフォーマーを活用した確率モデルで動作、トレーダーの意思決定を予測モデルは個人情報を使わず行動パターンを分析するが、状況の文脈を失うと精度が低下する #生成AI・LLM#AIエージェント#機械学習
@Ryo Hirayama / 13日前 Tauto で型付き言語を作る: 型付け規則から証明付きの検査器を生成する Tautoを使って型付け規則から証明付きの検査器を生成する方法を紹介しているinductive_syntax!で構文木の型を生成、@mode!で型検査器と証明を自動生成型検査器の健全性と完全性を定理として証明し、評価器の型安全性を別途証明する必要がある #生成AI・LLM#AIエージェント#機械学習
@kikuziro / 14日前 新しいRAG「Decision RAG」は速い!安い!上手い!🍜 DecisionRAGは判断モデルを使ってRAGの検索を改善した階層構造で検索を絞り込み、Jevで確からしさを評価する階層データの保守コストと鮮度が回答精度に直結する #生成AI・LLM#RAG#機械学習
@ryo33 / 14日前 AIに証明を書かせてセキュアに開発する言語 Tauto をリリースしました! Tautoという言語でAI生成コードの正しさを証明できるようにした命題として性質を記述し、証明をコードで書くことで機械が検証、依存型で制約を追加証明の対象外のコードはテストなどで確認する必要がある #生成AI・LLM#AIエージェント#機械学習
@OH-GY / 14日前 RAGが一度も効いていなかった話 RAGは資料検索を一切行わず、作り話の返答をしていた埋め込みモデルが文類似度用で検索用ではなかった、資料の主語が不明で取り違えが起きた資料に主語を明記し、1位と2位の距離の比でしきい値を判断する必要がある #生成AI・LLM#RAG#機械学習
@Melville / 15日前 ペイントツール上でニューラルネットワークを動かす ペイントツールKritaで手書き数字を認識するニューラルネットワークを実装したGemmとReLUをフィルターとレイヤーで再現し、72次元の隠れ層で98.40%の正答率を達成手書き文字認識はペイントツールの標準機能でも可能で、タスク自体が簡単であることが分かった #フロントエンド#AIエージェント#機械学習
@ShozoTanaka / 15日前 16GB RAM・6GB VRAM のノート PC で gpt-oss-20b とチャットする 16GB RAM・6GB VRAM のノート PC で gpt-oss-20b を動作させた専門家は CPU に残し、それ以外を全層 GPU に載せる。CPU の重みはファイルを写したまま読むモデルは 1 つだけ開くことで RAM と VRAM の使用量を抑える #生成AI・LLM#AIエージェント#機械学習
@Ivan Mehta / 16日前 DoorDash、AIエージェントからの注文は「数え切れないほどの数百件」にとどまる DoorDashはAIエージェントからの注文が「数百件」にとどまっていると明らかにしたMuseやInstinctなどの第三者エージェントとDoorDash独自のテキストから注文するエージェントが対象、1日300万件の注文と比較AIエージェントによる注文はまだ限定的で、実際の利用はアプリ経由が主流のため、開発者は現状を把握する必要がある #AIエージェント#機械学習#クラウド
@宮木翔太 / 16日前 製造業で Jev はどう使える?4チームで挑んだ1週間のユースケース探索 製造業現場でJevを活用した4チームのユースケース検証が行われたチームAは作業者の割り当て、チームBは時系列データの異常検知、チームCはフィジカルAIの意思決定、チームDは火災時の避難誘導を検証Jevを低コストで判断モデルとして活用する際、自然言語の解釈やリアルタイムの行動選択に適していることが分かった #AIエージェント#機械学習#クラウド
@nakamura / 17日前 需要予測モデルで「雨」を予測してみた 雨の降水量を予測するモデルで、毎日0mmと予測するモデルが最も誤差が小さかった毎日0mm、前日と同じ、例年並み、ARIMA、Croston、Chronos-Boltなどのモデルが比較され、誤差と捕捉率・空振り率で評価された日次と月合計の精度を求めるかでモデルの順位が変わるため、予測対象の粒度を事前に決めることが重要 #機械学習#DevOps・CI/CD#テスト

 最終更新 2026/11/16 11:31