@Hiromu Ogawa / 1日前 BigQuery 会話分析 データエージェント超入門【利用編】 BigQueryデータエージェントは検証済みクエリと指示を元に質問に回答し、予測機能は設定によって制限される検証済みクエリが使われた場合は「Verified Query」表示、予測機能は指示で断る設定が可能、データポータルからアクセスする際の権限設定が必要予測結果の信頼性を確認するにはSQLと実績データを照合し、データポータルでのアクセスにはIAM権限とプロジェクト設定が必要 #クラウド#バックエンド#データ分析
@Hiromu Ogawa / 1日前 BigQuery 会話分析 データエージェント超入門【作成編】 BigQueryでデータエージェントを作成し、自然言語でクエリを実行できるように設定知識源にテーブルを指定し、用語集と検証済みクエリで回答の定義を明確化、実行制限を設定データエージェントの利用にはBigQueryの読み取り権限とクエリ実行権限が必要で、費用はクエリ量に応じて発生 #クラウド#バックエンド#データ分析
@tikeda123 / 1日前 「当てる」だけでは足りない ― Numeraiに学ぶ、クオンツ戦略を評価する5つの原則 Numeraiの報酬は単体の予測力に加えて「みんなの予測にない部分が実際に当たったか」で決まるMMC(メタモデル貢献度)と相関スコアの両方を考慮し、木系モデルとベンチマークとの差分を学ぶ手法が使われる予測と損益の相関を実測で確かめ、資金配分は事前の基準で段階的に進めることが重要 #AIエージェント#機械学習#データ分析
@Chengkai Yan / 1日前 SAP BDCナレッジ集:Delta SharingでDatasphereとSAP Databricksをつなぐ SAP Datasphereに登録したCSVデータをDelta SharingでSAP Databricksに共有する方法を紹介Data Product作成とDelta Sharing経由の共有、Local Table (File)の作成が主な手順SAP Databricksから直接参照できる状態にするにはSAP DatasphereでのData Product準備が必要 #クラウド#データ分析#インフラ
@Kirsten Korosec / 1日前 あなたの車とモバイルアプリはおそらくテクノロジー企業にさまざまなデータを渡している 車載システムとモバイルアプリがユーザーのデータをテクノロジー企業に送信している17社の自動車メーカーの21台の車両と30のモバイルアプリが第三者にデータを送信し、VINやメールアドレス、正確な位置情報が含まれたユーザーは車両の機能を使わなければデータを防げず、広告やデータブローカーに個人情報が売却される可能性がある #クラウド#セキュリティ#データ分析
@udowanllc / 1日前 退会者の免許証画像が660万件も漏洩。あなたの会社にも「消されていないデータ」がないか? 大規模な情報漏洩が660万件発生。退会者の免許証画像が残っていた既知の脆弱性の放置、本番DB以外からの流出、使っていないデータの保持が原因。Metabaseの脆弱性やEOLフレームワークの使用が挙げられる退会者のデータがどこに残っているかを確認し、保持期限を設定する。データ最小化が重要で、コストのかからない対策となる #セキュリティ#データ分析#インフラ
@KEI_YAMA / 1日前 geoparquet-io を使ったGeoParquet入門 GeoParquetは列指向ストレージで空間データを効率的に保存・クエリする形式である述語プッシュダウン、クラウドネイティブ、bbox列、ZSTD圧縮が特徴Row Groupサイズが64-256MBに収まるよう調整する必要がある #生成AI・LLM#クラウド#データ分析
@edinetty / 2日前 正確に取れない数字は出さない — 4,000社の財務データで選んだ「諦めて注記する」設計 財務データ処理で不正確な数字は出さない方針を取っている会社ごと・項目ごと・業種ごと・年度ごとの4段階で諦めを設計し、近似値や非該当マークを注記データの欠損を「取得失敗」「存在しない」「近似値」などに区別し、注記を付けることで信頼性を保っている #データ分析#バックエンド#インフラ
@Tim De Chant / 2日前 AIブームが気候変動週間を席巻し、一部のクリーンテックスタートアップがAI関連の資金調達に依存している AIブームが気候変動週間に影響を与え、クリーンテックスタートアップがAI関連の資金調達に依存しているデータセンター建設に伴うエネルギー需要と、他の気候技術分野が見過ごされるリスク、資金調達の傾向クリーンテックスタートアップはAIブームに合わせた戦略を取るが、長期的な気候目標への焦点が失われるリスクがある #AIエージェント#機械学習#データ分析
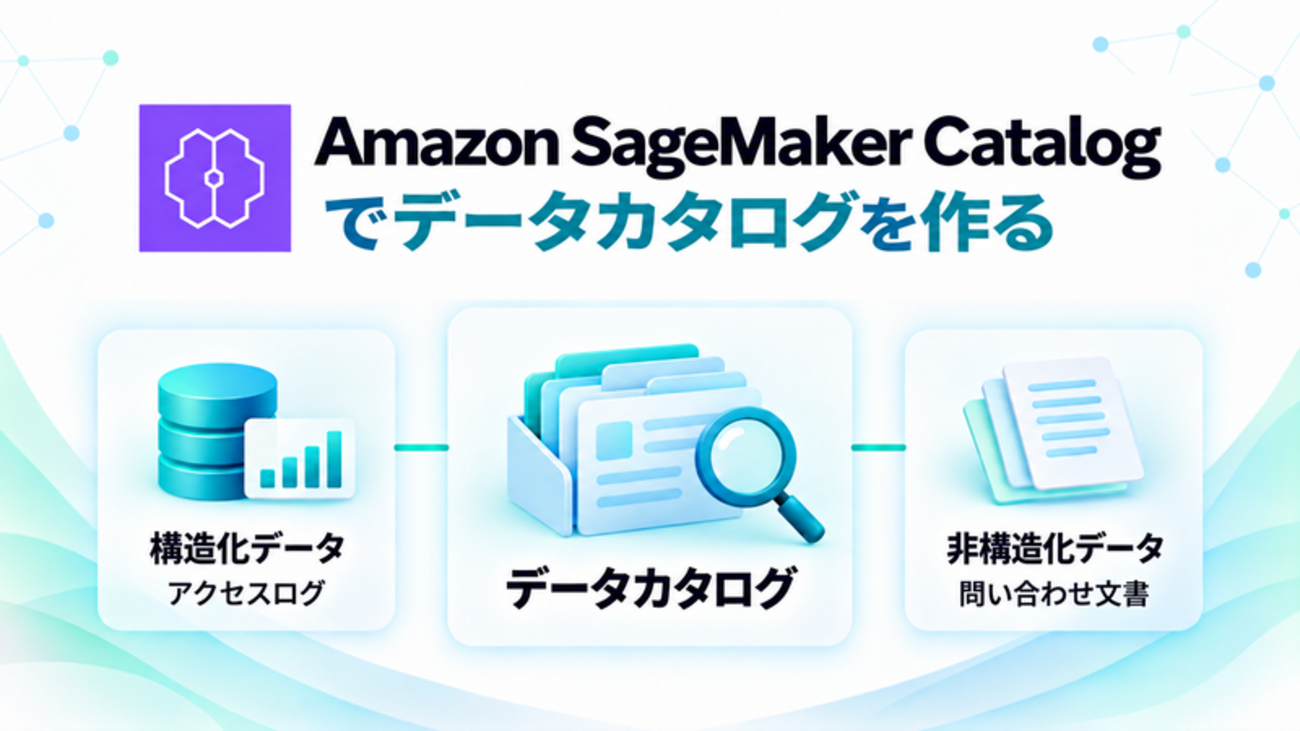
@Taste of Tech Topics / 3日前 Amazon SageMaker Catalog でデータカタログを作る Amazon SageMaker Catalogでアクセスログと問い合わせデータをカタログ化する方法が説明されているアクセスログはテーブルとして登録し、問い合わせデータはS3バケットを接続してカタログに公開する。ビジネスメタデータとスキーマを設定し、データエージェントとAthenaで集計、Bedrock Knowledge Baseで類似検索を行うカタログ化したデータを活用する際には、リクエスト数やメタデータ保存量の無料枠を確認し、利用するサービスごとの料金を別途確認する必要がある #クラウド#データ分析#DevOps・CI/CD
@y0shidahr / 4日前 DatabricksとSnowflakeどっち?を毎回聞かれるので、機能表じゃない選び方を書く DatabricksとSnowflakeの選定は機能比較ではなく運用・コスト・チームの言語で決まるSnowflakeはクレジットとストレージ、DatabricksはDBUとクラウドVMコストが異なる、SQLかPythonかのチーム言語が重要SQLしか使わないチームはSnowflakeが運用しやすく、Python・MLが必要ならDatabricksが機能面で優位 #クラウド#データ分析#アーキテクチャ
@Ayami Nishino / 6日前 SAP BDCナレッジ集:SACのQuick Builderを試してみた SAP Analytics CloudのQuick Builderでストーリーのテーブルを編集モードにせず変更できるメジャーの追加・削除、分析軸の変更、並び替え、フィルタ維持が可能、データソース変更や計算項目作成は不可Quick Builderで行った変更はストーリー編集で保存せず、ブックマーク機能で状態を保持する必要がある #クラウド#データ分析#バックエンド
@分析屋 / 6日前 統計検定データサイエンス(基礎と発展)の受験体験記 データサイエンス基礎と発展の試験内容と受験体験が紹介されているデータサイエンス基礎はExcelを使った関数や可視化、発展はAIや統計の知識を問う問題試験では数値や用語の入力が必要で、知識の定着が重要 #データ分析#テスト
@suzu_suzu / 6日前 SalesforceのデータをDr.Sumに定期的に取り込む(TROCCO活用例) TROCCOでSalesforceのデータをDr.Sumに転送する設定方法が紹介されている全転送と差分転送の2つの転送方法、UPSERT(MERGE)モードが使用されている全件洗い替えでは中間テーブルを経由してデータを更新する仕組みで、転送失敗時のデータ保持が可能 #クラウド#データ分析#DevOps・CI/CD
@RyoskDara_ / 6日前 Agent MetadataでDatabricks Genieの挙動はどう変わるか? Databricks GenieのAgent Metadataのsynonymsに社内略語を記載すると、ユーザーの質問に正しい指標を返せるようになるsynonymsに「解約率」と記載すると取引先ベースの指標を、別名に「ACV」と記載すると受注金額の指標を引き当てられる同じ言葉で複数の指標がある場合はsynonymsを記載しないと意図しない指標が返ってくる可能性がある #AIエージェント#生成AI・LLM#データ分析
@ennagara128 / 7日前 JSON.stringify/parseで、知らないと詰まる4つの落とし穴 JSON.stringify/parseでDateオブジェクトが文字列になるなど4つの落とし穴があるDateオブジェクトは文字列に変換され、undefinedプロパティは消える、配列のundefinedはnullに、循環参照はエラーになるDate型を使う場合は明示的に変換が必要で、undefinedの扱いや循環参照に注意する #フロントエンド#バックエンド#データ分析
@yutannihilation / 8日前 Parquet の仕様にも入った ALP (Adaptive Lossless floating-Point) とは何なのか Parquet 2.14.0でALPという浮動小数点数の圧縮方式が導入されたALPはZSTDと比較して処理速度が速く、eとfのパラメータでデータを圧縮する仕組みALPは10進数のデータに最適だが、センサーや計算結果のような2進数データでは圧縮率が低下する可能性がある #クラウド#データ分析#データベース
@Anthropic / 8日前 ClaudeがCRISPRに似た新しい酵素系を発見 ClaudeがCRISPRに似た新しい酵素系を発見したCRISPRに似た繰り返し配列と逆転写酵素を含む、未知の酵素系が発見されたAIがデータを分析し、実験を補助する仕組みが実証された #AIエージェント#機械学習#データ分析
@Marina Temkin / 8日前 Snorkel AI、AIトレーニングデータ需要の高まりで評価額35億ドルに Snorkel AIが35億ドルの評価額を達成Series Eで3億5000万ドルを調達、データアズアサービスを提供AIトレーニングデータの需要が急増していることが背景にある #生成AI・LLM#AIエージェント#データ分析
@Tim Fernholz / 8日前 誰もがデータセンター建設に不満を持つ理由 データセンターコンストラクションに対する反対運動が広がっている地域住民の経済的・環境的懸念と、産業化の歴史的トラウマが主な要因、企業のプロパガンダとNIMBYの動きが対立データセンタープロジェクトの実施には地域との信頼構築が不可欠で、単なる技術的課題ではない #クラウド#インフラ#データ分析