@y.morimoto / 1日前 AI Slop なテストコードにならないためにどう対処するか? AIが生成したテストコードは品質を保証しないテスト設計を人間が行い、PRDやFigmaなどの上位文書をAIに提供するテスト仕様の作成はAIに任せず対話形式でレビューする #テスト#DevOps・CI/CD#アーキテクチャ
@wheesnoza / 1日前 LaravelのAI開発を支える品質検査と開発フロー LaravelでAI開発を支える品質ハーネスとして、静的解析やテストの結果を機械的に検証する仕組みを導入しているLarastanで型の不整合を検出、Pest Archテストで設計ルール違反を検出、Laravel Pintでコードスタイルを統一テストの実行結果と行カバレッジ100%を基準にし、ミューテーションテストで検証力の確認が必要 #バックエンド#DevOps・CI/CD#テスト
@就活の勝者_早稲田大学4年の就活日記 / 1日前 Google Cloud Professional Cloud DevOps Engineer 勉強時間は40時間。就活と並べて週5時間で8週間 Google Cloud Professional Cloud DevOps Engineerの試験対策に40時間かかる模試10回で20時間、復習に20時間、CI/CDとオブザーバビリティが試験の25%を占める試験の半分を占めるCI/CDと監視の分野を重点的に学ぶべき #DevOps・CI/CD#クラウド#テスト
@higu / 2日前 書いたテストはほんとにテストになっているのか— わざと壊して確かめる テストが書かれていても評価されていない、検出力が低下している状況を検出する方法を紹介検査の評価状況をJSONで確認、壊し方を1つずつ試して検出力確認、実行件数を固定して変更を検出検査が通るかどうかだけでなく、検査が実際に行われているか、壊したときに検出できるかを確認する #テスト#DevOps・CI/CD#アーキテクチャ
@ABAB↑↓BA / 2日前 AI開発時代だからこそ、テストの役割を見つめ直す AI時代でもテストの役割は変わらず、それぞれの種類で検出できる不具合の種類に応じて使い分けるべきユニットテストはロジックの細かい検証、E2Eテストは画面をまたぐ不具合の検出、型とlintで不具合を事前に防ぐテストの実行順序とコストの違いを意識し、型設計で不具合を防ぐことでAIのイテレーションを効率化できる #テスト#アーキテクチャ#DevOps・CI/CD
@hamham999 / 2日前 荒れたテストケースをコード管理で立て直してみた テストケースの管理をコードベースに切り替えることで問題を解消したケース定義をYAMLで管理し、CIでエラーと警告を検出、類似ケースの判定も行うスプシに取り込む際は実施結果が消えるためテスト中は取り込まないことに注意 #バックエンド#DevOps・CI/CD#テスト
@AIフクロウ|夜な夜なClaude Code / 2日前 夜間ジョブが朝まで固まっていた自作ツールの外部通信19か所を、Claude Codeに16分でタイムアウト棚卸し表(判定4種)にして、上限つきリトライまで入れてもらった夜 自作ツールの外部通信19か所をClaude Codeでタイムアウト棚卸し表にしたタイムアウトなし12か所、リトライ上限なし3か所、判定4種類で分類上限のないリトライは別枠で記載し、失敗時の影響を列に記載することで判断材料とした #バックエンド#DevOps・CI/CD#テスト
@haruyoshi_o / 2日前 AIだけで情緒評価ツールを作ってみた AIで情緒評価ツールを作り、7つの評価軸でWebサイトの感情的インパクトを測定信頼感・親近感・高級感・先進性・温かみ・行動喚起・印象の一貫性の7軸を定義、セクション単位で評価評価軸の定義が精度に大きく影響し、AIのズレを改善するためのルール追加が必要 #AIエージェント#フロントエンド#テスト
@タックルマン@日本○学 / 3日前 AWS DEA-C01 合格点の720点を、社会人の資格勉強で模試10回に割ってみた AWS DEA-C01の合格点720点を10回の模試に割って学習計画を立てる方法が紹介されている模試10回のうち後半3回で8割を取る目標、4分野の比重に応じた問題数配分、IT資格道場の問題集が教材として選ばれた理由非採点問題の存在により合格点ぎりぎりの力では採点問題の難易度次第で不合格になる可能性がある #クラウド#DevOps・CI/CD#テスト
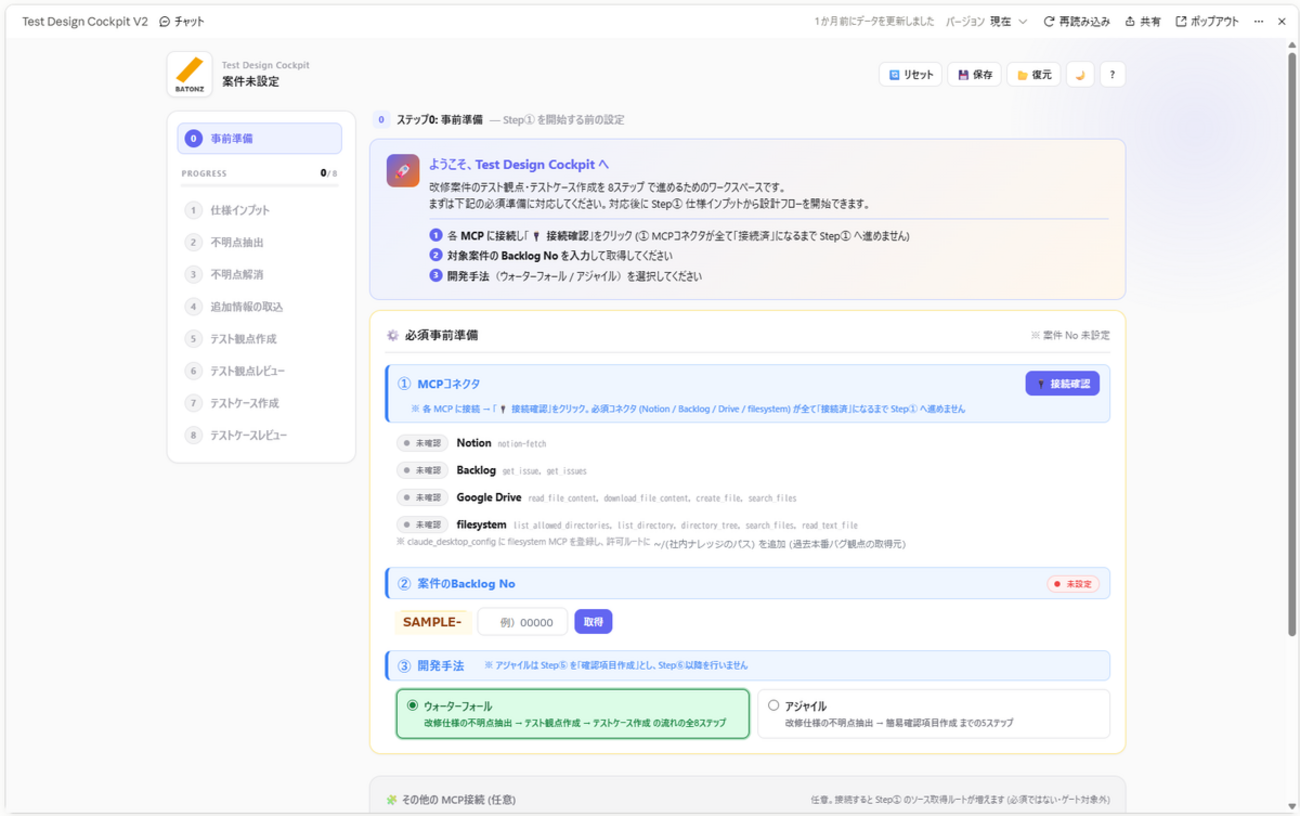
@BATONZ Tech Blog / 3日前 Claude Codeでテスト設計を自動化した話 ― Coworkのartifactから移行して、テスト設計を2時間に Claude Codeでテスト設計を自動化し、テスト設計時間を2時間に短縮した仕様と実装コードの差異検知、テスト観点の網羅性確保、プロンプトの抽象度向上プロンプトの精度向上には個別例の追加より抽象度の高い判断基準の設定が効果的 #DevOps・CI/CD#テスト#AIエージェント
@Giuliano / 3日前 Fuzzy Testing in Go Goのfuzzテストでコードのエッジケースやバグを自動検出できるseed corpus値を指定してf.Fuzz()でランダム入力を生成、JSONパーサーやURLパーサーのテスト例が示されるfuzzテストの結果は永続的なテストケースとして保存され、リグレッションを防ぐ #テスト#DevOps・CI/CD#バックエンド
@佐藤彩夏 / 3日前 AIテスターに渡す「判断基準」の書き方を、2回失敗して学んだ話 AIテスターに渡す判断基準を書く際、適用範囲や数値のレンジを明記しないと誤判定を起こす適用範囲を書かないとWebやデスクトップの違いをAIが区別できない、1点の数値を置くと正常値の両側が異常と判定される数値には実測レンジを書くことで正常値の両側を異常としないようにし、適用範囲を明記しないと誤爆する #AIエージェント#テスト#DevOps・CI/CD
@jqit-yukiono / 5日前 JenkinsのPRレビューでテストとセキュリティスキャンも回す ― AIのAPPROVEを機械的に覆すMineWatchのCI JenkinsでPRごとにテスト・セキュリティスキャンを実行し、AIのAPPROVEを機械的に覆す仕組みを構築シークレットスキャン・SAST・バックエンドテスト・E2E・依存脆弱性チェックをPRごとに実行し、検証が1つでもFAILならAIのAPPROVEを強制的にREQUEST_CHANGESに変換検証結果がFAILでもビルドを止まらせず、最終的なVERDICTで機械的に判定する設計で、AIの指摘が誤ってても実測で確認できる #DevOps・CI/CD#セキュリティ#テスト
@分析屋 / 6日前 統計検定データサイエンス(基礎と発展)の受験体験記 データサイエンス基礎と発展の試験内容と受験体験が紹介されているデータサイエンス基礎はExcelを使った関数や可視化、発展はAIや統計の知識を問う問題試験では数値や用語の入力が必要で、知識の定着が重要 #データ分析#テスト
@knaka / 6日前 Nuxt環境でVitestの速度を5倍早くした Vitestのisolateオプションをfalseに設定してテスト実行時間を5倍短縮したテスト環境の分離を解除し、モックの共通化とsetupFilesでの一括処理でテストの干渉を防いだテストファイルごとの環境作成時間を削減し、CIやローカルでの実行時間が大幅に改善した #テスト#フロントエンド#DevOps・CI/CD
@ikedan / 6日前 AIのテスト設計、90点未満は差し戻す AIが生成したテスト設計はルールベースの検証では不十分で、多段パイプラインで採点と敵対レビューを組み合わせて品質を確保する採点器(100点満点で90点未満は差し戻し)と、生成文脈を知らない敵対レビュアーを組み合わせ、調査・観点シート・テストケースの展開を分離する90点未満のテスト設計は減点理由とともに再生成されるが、敵対レビューで採点器が見逃した欠陥も検出する #テスト#AIエージェント#DevOps・CI/CD
@泡沫京水 / 6日前 セマンティックなHTML構造はテストすらわかりやすくする セマンティックなHTML構造を使うことでテストの可読性とアクセシビリティが向上するgetByRoleでロールとaccessible nameで要素を検索、セマンティックタグでロールとnameを自動設定テストコードがクラス名に依存せずロールとnameで要素を検索するため、実装変更に強いテストが作れる #フロントエンド#テスト#セキュリティ
@mpyw / 6日前 重複エラーログ根絶 Linter: errlogreturn Goのエラー処理でログとreturnを同時に使うコードを検出するlinterが公開されたログに出したエラーとreturnするエラーが同じ場合に指摘し、ラップ・フォーマット・構造体・ヘルパー経由のケースも対応ログとreturnの両方を含むコードはエラー件数が増えるため、1か所に集約する運用が推奨される #バックエンド#DevOps・CI/CD#テスト
@blinkgroup_jp / 9日前 Flaky Test(不安定なテスト)の主な原因と実務で使える具体的な改善手順・チェックリスト Flaky Testの主な原因と改善手順が解説されている非同期処理の同期ズレ、テストデータの競合、時間依存処理、環境依存が原因。オートウェイティングやテストデータの独立性確保が対応策テストのリトライ機能を過度に頼らず、テストデータの独立性を確保する運用ルールを設けることが重要 #テスト#DevOps・CI/CD#アーキテクチャ
@Uyuki_0409 / 9日前 【Vitest】テストを書いてみた~振る舞いを仕様として残す~ Vitestでテストを書く際、振る舞いを仕様として残す方法を紹介したテストを前提・操作・結果の順で記述し、モック関数とReact Testing Libraryを組み合わせて画面の振る舞いを確認するテスト名に「未ログインの場合、投稿後にログイン画面へ遷移する」と記述することで意図が伝わりやすくなる #テスト#フロントエンド#DevOps・CI/CD

 最終更新 2026/10/01 16:40