@Fumiya Suto / 35日前 ICFPC 2026における人間とAIの共闘 ICFPC 2026でAIと人間が協働してプログラミングコンテストに挑んだAIにプログラムを書かせるか人間が手作業で書くかを柔軟に選択し、スコア改善にAIを活用したAI利用時のコストが高く、サブスクでないと厳しいことが判明した #AIエージェント#生成AI・LLM#DevOps・CI/CD
@Yasuhito Morimoto / 35日前 国内AIエージェント動向(2026/8/28号) 国内AIエージェントが会話から業務プロセス完遂へ移行し、KPI公開とセキュリティ対策が強化されている業務プロセス完遂、KPI公開、MCP・API連携、Agentic AIセキュリティ教育業務プロセスの完遂と結果評価が導入判断の軸となり、セキュリティ対策が不可欠になっている #AIエージェント#機械学習#セキュリティ
@ハイレゾ技術編集部 / 35日前 30B級ローカルLLM、現場で使うならどれ?Qwen3.8・Muse Glimmer・Gemma4を比較【要約・解説編】 Qwen3.8-27B、Muse Glimmer-30B、Gemma4-31B-itの30B級ローカルLLMが現場で使えるか比較されたMuse Glimmer-30Bは数式の表記と推論速度が優れている、Qwen3.8-27Bは内容の充実さが際立つMuse Glimmer-30Bは思考モードでも最速で、Qwen3.8-27Bは思考モードONで内容が最も充実しているが推論時間が長い #生成AI・LLM#AIエージェント#クラウド
@tyo / 35日前 AIエージェント時代のクリエイティブ。 DHH DHHがAIエージェントに実装を委ね、人間の役割はビジョン提示と審美眼に変化したAIエージェントが自律的にコードを生成し、人間はコードの形や比率を判断するAIに曖昧な指示を出し、返ってきた結果にフィードバックを繰り返すことで創造性が生まれる #AIエージェント#生成AI・LLM#バイブコーディング
@a_tochi / 35日前 【ADK2.0】実践② Google ADKで複数レビュアーを並列実行(Fan-out / Fan-in) ADK2.0で複数レビュアーを並列実行するワークフローを構築したFan-out/Fan-inで複数ノードを並列実行し、JoinNodeで結果を集約し、ループで再レビューを実装ループは特別な構文ではなくエッジ定義で表現できるが無限ループ対策は自分で考える必要がある #AIエージェント#DevOps・CI/CD#アーキテクチャ
@Ryotaro / 35日前 AI に Slack の DM まで読ませていませんか ユーザーごとに専用のSlackアプリを払い出し、bot tokenと最小scopeをAIに渡すことでSlackを安全に操作できるbot tokenと最小scopeをAIに渡す設計、user tokenを使わずbotを招待したchannelだけを視界に設定AIの視界はbotを招待したchannelに限定され、操作はbot名義で記録されるため後から区別可能 #AIエージェント#バックエンド#クラウド
@Knowledge Work Developers Blog / 35日前 FDEはスーパーエンジニアの仕事ではない。ナレッジワークがAI×組織力で挑む顧客課題解決の新しい形 FDEはエンジニアが顧客の現場に直接出向き、AIエージェントを開発する新しい働き方エンジニアとエージェントストラテジストがチームで顧客の課題解決に取り組み、知見をプロダクトに還元するFDEはチーム戦で取り組むことで、エンジニアのスキルを広げながら顧客の課題に柔軟に対応できる体制を構築している #AIエージェント#バックエンド#フロントエンド
@nakamizu / 35日前 AIで作る資料を、規範・手順・検査で整える AIで作る資料の品質を規範・手順・検査の3層で管理する仕組みを紹介規範で文章の判断基準を定め、手順で作業順を統一、検査で違反を自動修正規範に沿った書き方と検査で、読み手の判断に必要な情報が伝わるようにする #AIエージェント#生成AI・LLM#バイブコーディング
@Mizuki Hiraishi / 36日前 メモリ16GBのMacBookでGemma 4 12Bを動かすためのllama-serverセットアップガイド llama-serverでMacBookのメモリ16GBでGemma 4 12Bを動かす方法が説明されているllama.cppのインストールとソースからビルド、量子化手法のQ4_K_MとUD-Q4_K_XLが選べるメモリ使用量を減らすために-ctk q8_0や-ctv q8_0を指定する必要がある。 #生成AI・LLM#AIエージェント#機械学習
@wfukatsu / 36日前 【チームによるAI駆動開発の勘所:第8回】Claude Code で貯めた知見を、 Plugin にして、配れる形にする Claude Codeのプラグドインとしてチームの知見を配布する方法が説明されているプラグイン構成でskills/を.claude-plugin/に入れないこと、hooks/hooks.jsonにガードレールを配置すること、READMEに外し方を記載することプラグインの誤検知率が低いことを実データで示さないと組織強制配布できないこと、.mcp.jsonの接続先が社内からしか解決できない場合の注意点を事前に記載すること #AIエージェント#生成AI・LLM#DevOps・CI/CD
@NTTDATA-Kyushu-Cloud / 36日前 第4話 とある現場のおじさん、MermaidでLLMに歩み寄る Mermaidを処理の流れをLLMに伝える共通言語として使う方法が紹介されている処理の順番を矢印で表せる、条件分岐を明示できる、状態を外に出せるMermaidの記法に慣れる必要があり、処理を詰め込みすぎると見づらくなることに注意が必要 #AIエージェント#生成AI・LLM#バイブコーディング
@タカジロー / 36日前 ChatGPTは“初手”で決まる──良い指示書は、AIに推測させない AIに推測させないための指示書が重要AIは情報が足りない場合でも推測して回答する、前提共有が鍵初手で最低限の前提を共有することで、後々の修正コストを減らせる #AIエージェント#生成AI・LLM#バイブコーディング
@tomohisa / 36日前 MacBook Pro 128GB でローカル LLM がついに実用になった ─ Qwen3.8 Flash Next 実測 MacBook Pro 128GBでQwen3.8 Flash NextがローカルLLMとして実用になったQ3量子化で90GBのGGUFモデルをllama.cppとOpenCodeで実行、コンテキスト長65536で動作128GBマシンでMoEアーキテクチャのモデルを動かす際、KVキャッシュのサイズとセッション数のバランスが重要 #生成AI・LLM#AIエージェント#機械学習
@inoyu-qiita / 36日前 「お前がみろ」はAIに効くのか。高圧的なプロンプトで回答精度を検証した 高圧的なプロンプトがAIの回答精度を上げるとは限らない丁寧さの研究では性能低下や向上が両方ある、具体的な指示が効果的高圧的な口調より、比較対象や検証方法を明確にしたプロンプトが重要 #生成AI・LLM#AIエージェント#機械学習
@haru-qiita / 36日前 なぜプロンプトを直しても、AIの出力は安定しないのか プロンプトを直してもAIの出力が安定しないのは、味付けと動線の設計のどちらを直すべきかを見誤っているから味付けは同じ処理内の調整、動線は材料と工程の流れの問題、評価で原因を特定する同じ評価例で修正を試し、改善したかを確認する際は一箇所ずつ直すことが重要 #生成AI・LLM#AIエージェント#RAG
@moritalous / 36日前 10年分ぐらいのQiitaの自分の投稿を蒸留したら、自分っぽい記事を書いてくれるようになったww 自身の過去10年分のQiita投稿を元にした記事作成スキルを開発したQiitaAPIで投稿を取得し、Markdown形式で保存、スタイルを学習させて文章生成スキルを作成生成した記事のスタイルがややAIっぽく感じられるため、改善が必要であることを確認した #生成AI・LLM#AIエージェント#OSS
@大森 / 36日前 AI開発の3つの壁を越えるための規約・仕様書・スキルの整備 AI開発の3つの壁を越えるための規約・仕様書・スキルの整備が行われたレイヤー単位の規約と仕様書でAIの判断を制限し、スキル分割でトークン消費を削減規約と仕様書の両方が揃わないと効果が得られないことが明記されている #AIエージェント#アーキテクチャ#DevOps・CI/CD
@hiroyuki.matsuda / 36日前 【Nishika 論文サク読み 第22回】複数のレア語が競合して学習が壊れる、を消した損失設計(COALA) COALAは複数のレア語が競合して学習が壊れる問題を解決する損失設計を提案MPD-Lossで正解語1つ vs 負例集合の正規化、DPD-Lossで語ごとの独立した二値分類を採用絞り込みフィルタとしての運用には閾値が必要で、K=10固定のため11語以上の発話は取りこぼす可能性がある #AIエージェント#生成AI・LLM#機械学習
@taketoshi kinoshita / 36日前 量子コンピュータは機械学習の特徴量生成に使えるのか?――社債取引の約定確率推定論文を読んで、アドテクへの応用を考える 量子コンピュータを特徴量生成器として利用し、機械学習モデルの予測性能を向上させる手法が提案された市場データを量子回路に埋め込み観測量の期待値を特徴量に変換し、実機ノイズとイベントマッチングによる特徴量再利用が行われた実機ノイズが予測性能に与える影響はまだ十分に解明されておらず、イベントマッチングによる特徴量再利用が実用性を高める可能性がある #AIエージェント#機械学習#インフラ
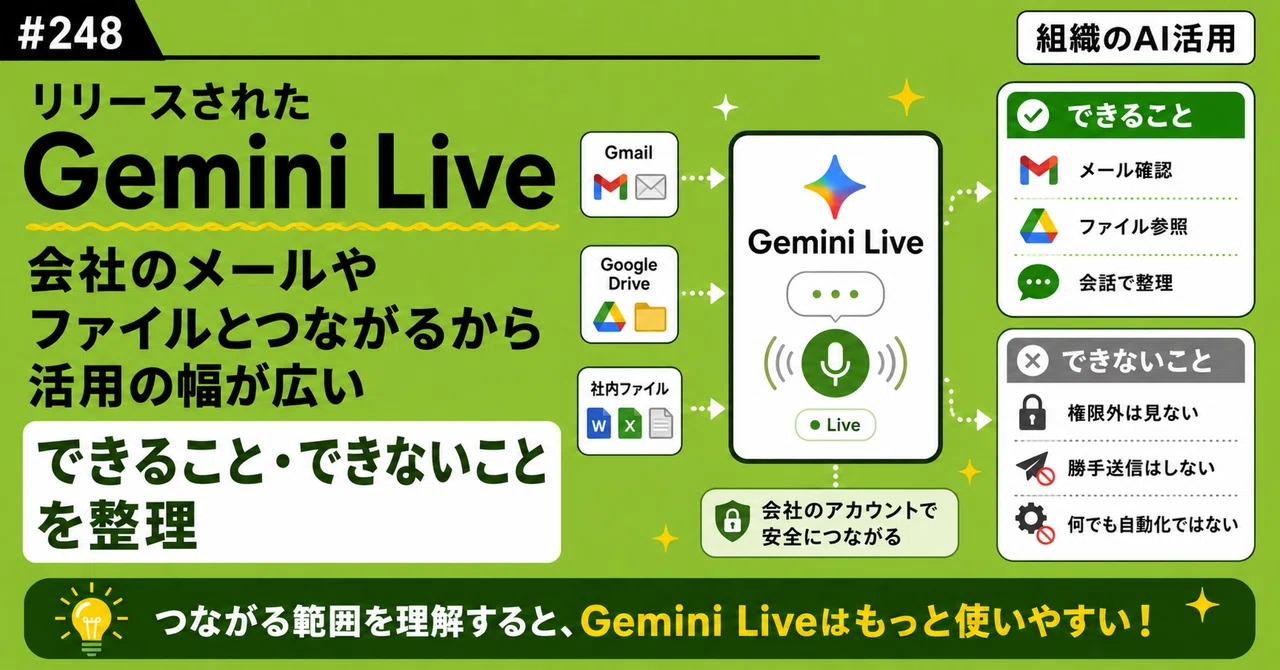
@寺田昇平 | AI Digital Community代表理事, AI Portalize CEO / 36日前 【組織のAI活用#248】リリースされたGemini Liveは、会社のメールやファイルとつながっているから活用の幅が広い。できること・できないことを整理しました。 Gemini LiveはGoogle Workspaceと連携し、音声で会社のメールやファイルにアクセスできるGmailのメール検索・要約、ドライブのファイル読み込み、カレンダー確認、新規ドキュメント作成が可能。既存ファイル編集やメール送信は不可音声で情報を引き出し、下書きを作成する使い方が現実的。マイドライブの整理を事前に決めておく必要がある #生成AI・LLM#クラウド#AIエージェント
 最終更新 2026/10/03 09:40