@Russell Brandom / 40日前 AI決定モデルがコンテンツモデレーションを変える Musubiがコンテンツモデレーション用の決定モデルPolicyLM-1.7Bを公開した決定モデルはリアルタイムでポリシーを適用し、LLMの柔軟性を活かして再トレーニング不要で動作するポリシー変更時にモデル再トレーニングが不要で、運用コストが抑えられる #AIエージェント#生成AI・LLM#機械学習
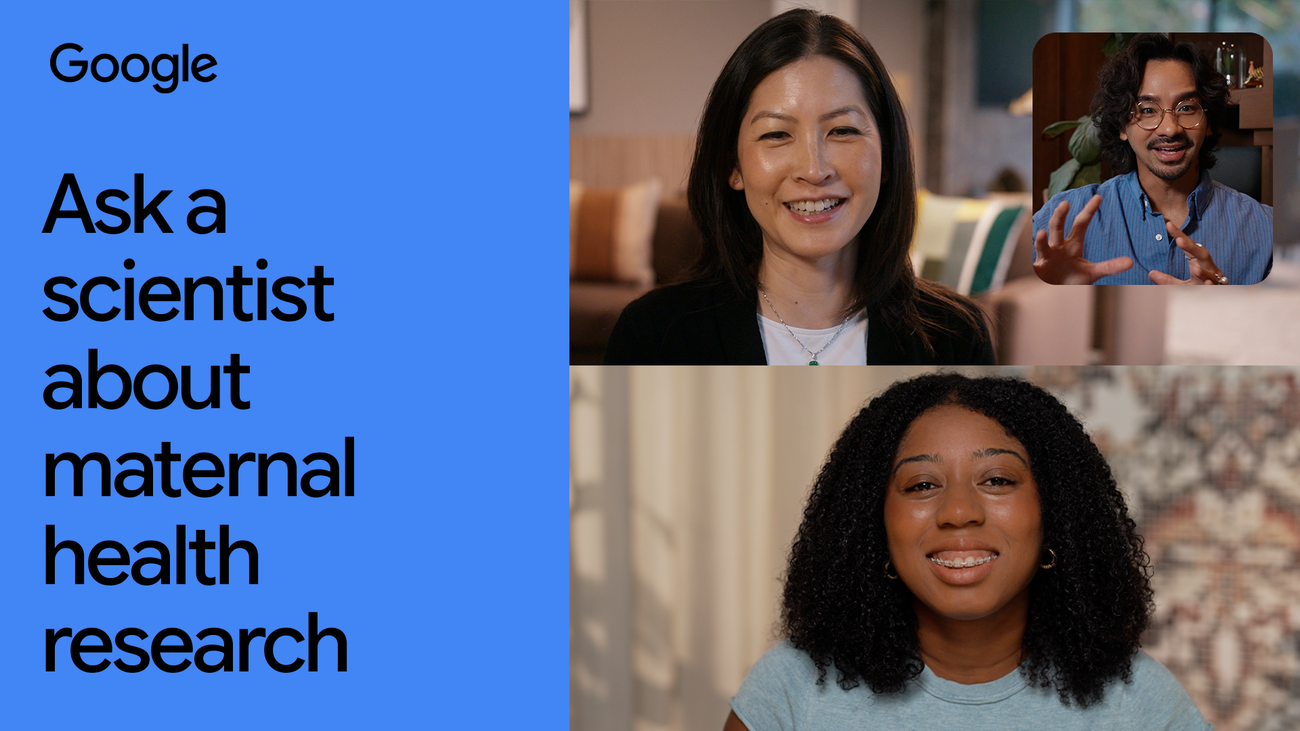
@Lindsey Lanquist / 40日前 妊婦の超音波検査アクセス向上に向けたAI活用 Google研究者はAIを活用して妊婦の超音波検査アクセスを改善している医療従事者に「ブラインドスイープ」超音波検査を8時間で訓練し、機械学習モデルで結果を解釈する超音波検査の実施者が専門技術者でなくても可能になるが、AIモデルの正確性が結果に大きく影響する #AIエージェント#生成AI・LLM#機械学習
@Rebecca Bellan / 40日前 Mirror Particleは人間の行動を予測する『世界モデル』を構築中 Mirror Particleは人間の行動を予測するための世界モデルを構築しているLLMの限界を指摘し、視覚的認識や社会的知性を含む独自の基礎モデルを構築している人間の行動変化を長期的に追跡し、動機の変化を分析するアプローチが特徴的 #AIエージェント#生成AI・LLM#機械学習
@Anna Heim / 40日前 Mistralの新しい1Tモデルは閉鎖型とオープン型のライバルを凌駕することを目指す Mistral AIが1TパラメータのマルチモーダルモデルMistral Large 4を公開した1Tパラメータでオープンウェイトモデルではないが3週間後に公開予定、NVIDIA GPU4000台で訓練オープンウェイトモデルのセキュリティ対策と特定分野での競合他社モデルの性能向上が注目される #生成AI・LLM#AIエージェント#機械学習
@tikeda123 / 40日前 「ドル円は上がるか」から「どの通貨が強いか」へ ― 通貨クロスセクション・モメンタムの仕組みと限界 クロスセクション・モメンタムは通貨間のリターン差を予測する戦略で、MOM(1,1)はコスト控除前年9.46%の収益を示したMOM(1,1)は過去1か月のリターンで並べ、1か月保有する戦略で、キャリートレードやMAルールでは説明できない収益があったコスト控除後は年3.92%に低下し、先進国通貨に限定すると収益が大きく低下する #機械学習#フロントエンド#バックエンド
@よさ / 40日前 1年かかるはずだった分析からAIモデル改善までを、3日で実現した Claude Codeを活用してA/Bテストの分析から推薦モデル改善までを3日で完了ai-analystリポジトリにドメイン知識を格納し、サブエージントでSQL実行とレポート作成、Opusで報酬設計とパラメータチューニング分析と実装を分離してもレポートと指標定義を残せば改善サイクルを継続可能で、人間の役割は問いと方針設定に集中できる #AIエージェント#生成AI・LLM#機械学習
@koki takeishi / 40日前 Context Ontology Acceleratorの仕組みを理解する Context Ontology Acceleratorはデータの意味と関係をオントロジーで管理し、AIエージェントが質問に応じた回答を生成するオントロジーでデータの概念と関係を定義、指標で計算式を登録、文書で根拠を説明、自然言語からSQLを生成する機能があるオントロジーの定義が不完全だと生成されるSQLの結果が変化するため、データの意味を明確に定義する作業が重要 #AIエージェント#生成AI・LLM#機械学習
@Rebecca Bellan / 41日前 Reflection、中国モデルと同等の性能を低コストで実現するオープンAIモデルBeamを発表 ReflectionがBeamというオープンなAIモデルを発表し、中国モデルと同等の性能を低コストで実現Beamは5010億パラメータで230億アクティブパラメータ、GLM-5.2と同等の性能を3〜4倍少ない計算コストで達成企業や政府が独自のAIシステムを構築するための「AIファクトリー」戦略を採用し、NvidiaのGPUを活用する #生成AI・LLM#AIエージェント#機械学習
@Jagmeet Singh / 41日前 HackerRankのAIインタビュアーが求人評価の未来を示す HackerRankがAIインタビュアーChakraを一般提供し、求人評価の仕組みを変えるAIが答えだけでなく、問題の解決プロセスやAIとの連携能力を評価し、従来の3段階の採用プロセスを1つに統合するAIによる評価は企業が測定できる指標を拡大するが、バイアスの問題や規制対応が求められる #AIエージェント#機械学習#キャリア
@Michelle Zhou / 41日前 ReviewBench: AIコードレビューのオープンベンチマーク GitHubがAIコードレビューのオープンベンチマーク「ReviewBench」を公開したRAGとLLMの比較、コード変更とリポジトリコンテキストの処理が主な機能開発者はAIの出力を厳しく評価するスキルが必要 #AIエージェント#生成AI・LLM#機械学習
@TechCrunch Events / 41日前 Open or closed AI? How founders are choosing what to build on at TechCrunch Disrupt 2026 AIスタートアップがモデル選択を柔軟に行うようになった複数モデルの利用、カスタマイズ、ハードウェアとの連携が議論されているモデル選択はコスト・パフォーマンス・柔軟性のバランスを取ることが重要 #AIエージェント#生成AI・LLM#機械学習
@Gen Tamura / 41日前 データ量を 4 分の 1 にしても答えが大きく変わらないのはなぜか?LLM の 4bit 量子化の仕組み LLMの重みを4bitに量子化しても性能が大きく変わらないのは、外れ値を避けてグループ単位で量子化し、要所を混合精度で残す工夫があるから外れ値は活性値に集中して4bitにしない、グループサイズで巻き添えを防ぐ、埋め込み層など要所を6bitで残す4bitにしたモデルは重みの3分の1まで削減可能だが、外れ値対策と混合精度で性能を維持している #生成AI・LLM#機械学習#AIエージェント
@mizchi / 41日前 俺のAIプログラミング手法(2026/10/05) AIプログラミング手法として、人間の役割と評価指標の定義、ループ構築、形式手法の活用が提案されている評価指標の改善とCIのチューニング、形式仕様の検証にTLA+やZ3の使用が挙げられている評価指標の数値化が重要で、主観的な判断は避け、具体的な数値に落とし込むべきである #AIエージェント#生成AI・LLM#機械学習
@レトリバ広報 / 42日前 in silico オフターゲット解析に向けた近似文字列探索の高速化 in silicoオフターゲット解析の近似文字列探索を高速化する手法が提案された双方向FM-indexとバッチ処理、プリフェッチを組み合わせて、ハミング距離とレーベンシュタイン距離の両方で検索を高速化ハミング距離ではバックトラッキングより10.7倍高速、レーベンシュタイン距離では6.8倍高速で、延伸回数も半分に削減された #AIエージェント#機械学習#データ分析
@レトリバ広報 / 42日前 学習型スパース検索における語彙選択 学習型スパース検索モデルの語彙選択手法が検証されたExpanded-SPLADEとハイブリッド型語彙、Top-BとGreedyの選択手法が比較された語彙サイズを固定した上で、反復スコアや関連度を用いた選択が有効であることが示された #AIエージェント#機械学習#インフラ
@Anthony Ha / 42日前 トランプ、新たなスーパーアイテキフォースを発表 トランプ大統領がスーパーアイテキの力の設立を発表したスーパーアイテキフォースは国家情報長官が率い、AIを「スーパーアイテキ」と再定義するAIの進展をリードし、規制の過剰を防ぐことが目的で、120日以内に報告書を作成する #AIエージェント#生成AI・LLM#機械学習
@sakai1250 / 42日前 結局、Looped Transformerってなんや? Looped Transformerは同じTransformerブロックをdepth方向に繰り返して使うアーキテクチャ同じ重みを繰り返し適用するweight-sharingと、反復アルゴリズムに適した構造の違い、test-time computeの増加方法loop数を増やしても性能が必ずしも向上しない、停止条件の判断が難しいなどの課題が指摘されている #生成AI・LLM#AIエージェント#機械学習
@Anthony Ha / 43日前 OpenAIの安全担当社員が「文化は破綻している」と退職 OpenAIの安全担当社員が文化の破綻を指摘して退職安全報告書の作成経験者で長年勤務、シリコンバレー全体の文化問題と指摘、AI開発の安全対策を核電所や空港のように厳格にAI開発企業は人間のミスを防ぐための冗長性と計画性が求められる #AIエージェント#生成AI・LLM#機械学習
@Dominic-Madori Davis / 43日前 Spotify億万長者の身体スキャンスタートアップが米国に進出 Neko Healthが米国に進出、AI技術を活用した健康スキャンを提供AIによる画像認識と血液・代謝のスキャン、500ドルの料金設定保険対象外だが健康増進に向けた予防医療の新たな選択肢となる可能性がある #AIエージェント#機械学習
@Sarah Perez / 44日前 Apple、AIエージェントのリスクを理由にmacOSのフルディスクアクセス制限を強化 AppleはAIエージェントのリスクを理由にmacOSのフルディスクアクセス制限を強化するフルディスクアクセスはアプリにファイルやメッセージの読み取り権限を与える設定で、AIエージェントがシステム全体にアクセスできるようになったユーザーが明確な操作をしないとアクセスを許可できなくなるため、開発者には新たな制限が課される #AIエージェント#セキュリティ#機械学習

 最終更新 2026/11/16 12:31