@Aisha Malik / 22日前 Instacart、AIスーパー買い物アシスタント「Clementine」をリリース InstacartがAI買い物アシスタントClementineをリリース自然言語やレシピからカート作成、手書きリストの認識、カスタムレシピ生成ユーザーの予算や制限に合わせた提案と、手書きのリストを読み取る機能が特徴 #AIエージェント#生成AI・LLM#フロントエンド
@Ivan Mehta / 22日前 Suno、著作権訴訟の増加に伴い、ライセンス音楽で訓練された新しいモデルに置き換える Sunoは著作権問題に対応し、ライセンス音楽で訓練された新モデルをリリースしたSuno v6はWarner Music GroupやBMGなどの音楽ラベルから取得したデータで訓練され、v6 wildとv6 miniの2バージョンが追加された旧モデルは廃止され、ユーザーは新しいモデルで音楽の編集やリミックスが可能になるが、著作権問題は解決していない #生成AI・LLM#AIエージェント#機械学習
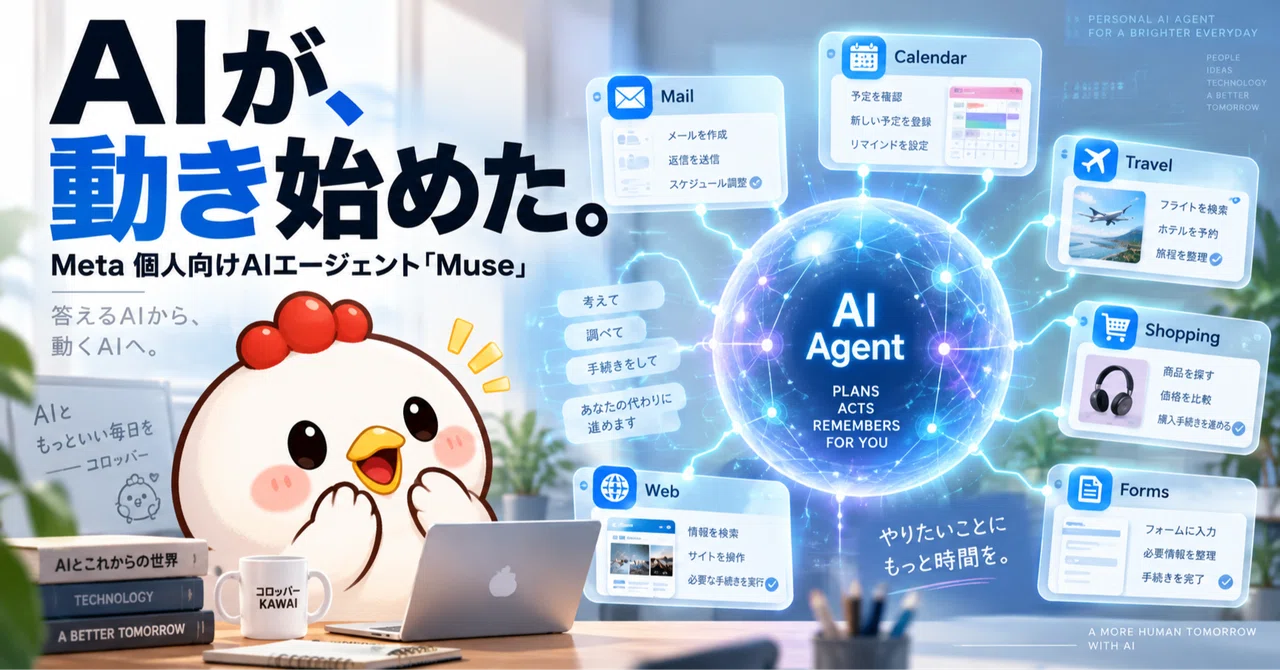
@コロッバーKAWAI / 22日前 AIは、ついに「答える」だけじゃなくなった。Metaが個人向けAIエージェント「Muse」を発表 Metaが個人向けAIエージェントMuseを発表し、作業を代行する機能を提供Museはメール送信や旅行予約、ブラウザ操作を代行し、Muse Secure VMで専用仮想マシン上で動作Museはユーザーの個人情報や操作を保護するためのセキュリティ対策を講じており、利用者は操作履歴を確認できる #AIエージェント#生成AI・LLM
@GENDA 公式アカウント / 22日前 数値と対話で見直し続ける生成AIツールの運用設計 生成AIツールの運用は数値と対話で見直し続ける仕組みを構築している利用実績と契約データを可視化し、利用者の声をヒアリングしてツール選択や利用枠を調整している利用量の変化や上限到達をきっかけに利用者と対話し、ツールの選定や契約を見直す判断材料になる #生成AI・LLM#AIエージェント#DevOps・CI/CD
@KenshoTakizawa@ベスト69元ゴルファーのエンジニア / 22日前 RAGの精度は「データ」で決まる — Contextual Retrievalを実測したら1位正解率が36%→100%になった Contextual Retrievalを導入すると検索の1位正解率が36%から100%に改善したチャンクの先頭にLLMが文脈を追加して索引化、検索精度向上とトークン削減が同時に実現検索精度向上は入力トークン数の削減に直結し、APIコストを下げることができる #生成AI・LLM#RAG#AIエージェント
@ntaka329 / 22日前 ローカルLLMには荷が重いと思っていた。39万字のエージェント作業を20回採点して見方が変わった ローカルLLMでエージェント作業が可能になったが、モデル選びで性能が大きく分かれるGLM-5.3-Flashは10本の和集合で58行を網羅、gpt-oss-120bは27行にとどまる。ツール呼び出しの継続性が鍵誤検知は回数を重ねると5.0倍に増えるため、温度0で1本52行・誤検知0の選択も有効 #生成AI・LLM#AIエージェント#クラウド
@ML_Bear / 22日前 LLMのトークン効率化で気をつけたいことまとめ 最新モデルを使い、キャッシュを活用してトークンコストを抑える最新モデルは低効率でも性能が高く、キャッシュの有効期限とキャッシュ範囲の設定が重要キャッシュ切れを防ぐためにはセッション内でモデルやeffortを変更しないこと、キャッシュ有効期限を確認すること #生成AI・LLM#AIエージェント#クラウド
@Marina Temkin / 23日前 Cognition、480億ドルの評価額で20億ドルを調達、AIコード生成市場に複数の企業が参入 Cognitionが20億ドルを調達し480億ドルの評価額を達成したDevinというコードアシスタントを開発し、Nvidiaサーバークラスタを借りて運用、オープンソースモデルに依存を減らす年間収益が40億〜50億ドルに達する見込みだが、計算リソースの制約が続く可能性がある #生成AI・LLM#AIエージェント#クラウド
@Sarah Perez / 23日前 Meta、個人向けAIエージェントMuseを発表。ユーザーの信頼は得られるか Metaが個人向けAIエージェントMuseを発表し、ユーザーの個人情報への信頼を問うMuseはメール送信や旅行予約など日常業務を処理し、StripeのLinkで支払いを処理、セキュリティとしてMuse Secure VMを採用Museは支払いカードが必要で、無料プランは利用量に制限があり、有料プランは月額20ドルから #AIエージェント#生成AI・LLM#セキュリティ
@Anna Heim / 23日前 Mistral、30億ユーロを調達し、国際的なAI戦略を強化 Mistral AIが30億ユーロを調達し、欧州の技術独立性を強調30億ユーロの資金調達、欧州での1ギガワットの計算能力構築、中国モデルのホスティング欧州の技術依存を減らす戦略と、国際的な投資家ネットワークの構築が成功の鍵 #生成AI・LLM#AIエージェント#クラウド
@oubakiou / 23日前 【godot-llm-gamebench】gemini-3.8-flashはEffortによってどのように性能が変わるのか Gemini 3.8 Flashのeffortを上げても自動テスト評価は伸びず、lowが最適な選択肢となるlowの自動テスト評価平均91.55、highは92.62で差は1.07点、コード品質はhighが3.92で最も高いlowが最安で最速かつ安定性が高く、コード品質を重視する場合にのみhighを選択すべき #AIエージェント#生成AI・LLM#DevOps・CI/CD
@就活の勝者_早稲田大学4年の就活日記 / 23日前 【27卒・28卒】就活で生成AIに任せていい仕事・ダメな仕事。答えを信じる前に確かめる4つ 就活で生成AIを使う際、任せていい仕事と任せてはいけない仕事の線引きが4つに分かれている締切の並べ替えと公式ページの確認は任せていい、試験中と個人情報の扱いは任せてはいけない試験中のAI利用は禁止されており、ESに個人情報は伏せるべきで、公式ページの確認は記載内容のみを基にさせる #キャリア#AIエージェント#生成AI・LLM
@ケン吉 / ゼロから作るAIアプリ開発 / 23日前 「自信満々に間違える」AIをどう直す?ログ異常検知のキャリブレーション問題とLoRD ログ異常検知モデルの過信問題を解決するLoRDという補正手法が提案されたオートエンコーダによる再構成誤差を活用した信頼性の距離計算と、確信度の補正ポリシー補正は予測ラベルを変更せず確信度だけを調整し、運用側に信頼できない予測のシグナルを伝える #AIエージェント#生成AI・LLM#機械学習
@ASUNI-NARE / 23日前 AIエージェントが「PCに入っている」時代へ。NVIDIA「RTX Spark」が変えるローカルAI NVIDIAがRTX Spark搭載PCを10月に発売し、ローカルAIとAIエージェントの導入を容易にするRTX SparkはGrace CPUとBlackwell RTX GPUを統合したSoCで、最大128GBのユニファイドメモリを搭載。Hermes AgentやOpenClawのローカルモデル導入を支援AIエージェントをワンクリックで導入できる仕組みが整い、ローカルAIの利用が一般化しやすくなる #AIエージェント#生成AI・LLM#クラウド
@花立 千紘 / 23日前 【AI VS 津軽弁】AIに「おばあちゃんの津軽弁」を聴かせてみたら未知の言語が爆誕した話 津軽弁の音声をAIが日本語として正しく認識できなかった音響モデルの濁音・スピード感、文脈のローカルな要素が認識の障壁となった音声認識の段階で日本語として処理できず、外国語として誤認識した #生成AI・LLM#AIエージェント#機械学習
@nolanlover0527 / 23日前 「なんか違う」を分解するだけで、AIの出力は劇的に変わる 「なんか違う」を「方向性」「粒度」「トーン」に分解することでAIに具体的なフィードバックができる方向性がずれている、粒度や量がずれている、トーンや形式がずれているの3つに分ける該当箇所と理想の状態をセットで伝えることで修正の精度が上がる #AIエージェント#生成AI・LLM#バイブコーディング
@じまさん / 23日前 AIコーディングエージェントを狙う攻撃あるけど、なんかしたほうがいいの? AIコーディングエージェントを狙う3つの攻撃手法と、各ツールの防御対策が紹介されている間接プロンプトインジェクション、MCP経由の攻撃、Slopsquattingが挙げられ、実行前の承認、サンドボックス、ネットワーク制御が防御手段各ツールのデフォルト設定でどれだけ防御できるかは異なるため、利用者は権限を絞ってレビューを挟む必要がある #AIエージェント#セキュリティ#生成AI・LLM
@quan_le / 23日前 Agent Harness:LLMとAIエージェントの間を埋める決定的なレイヤー Agent HarnessはLLMとコードリポジトリ間の決定的な中間レイヤーとなるフィードバックループ、ツール実行、コンテキスト管理、権限管理、検証、オーケストレーションの6つの領域を制御する実際のコード修正やテスト実行に必要な環境制御をシステム側で行う必要がある #AIエージェント#生成AI・LLM#DevOps・CI/CD
@ぜま / 23日前 ウィトゲンシュタインを通して見る生成AIの現在地 生成AIは言葉の使用から意味を理解できるが、生活経験の欠如により限界があるウィトゲンシュタインの言語ゲーム理論と単語埋め込みの統計的分析が中心。言葉の意味は使用に依存し、LLMは文脈に応じた応答を生成するが、感覚や身体経験の理解は不十分LLMは文法的・文脈的な理解は可能だが、感覚的・身体的経験に基づく判断は人間と差がある #生成AI・LLM#AIエージェント#機械学習
@分析屋 / 23日前 AI Coding Agentの活用 with GitHub Copilot ーPart2ー GitHub CopilotのCopilot ChatでAgentモードを実行するとAIがタスクを自律的に実行するAgentモードではLLMモデル選択、推論レベル、コンテキストサイズの調整が可能で、コード作成から動作確認まで一連の流れを実行AIクレジットの消費量を節約したい場合はAutoモデルを選択するのが良い #AIエージェント#生成AI・LLM#DevOps・CI/CD
 最終更新 2026/10/02 07:40