@Tim Fernholz / 10日前 OpenAIが新しいサイバーセキュリティモデルをリリース。それだけで十分か? OpenAIはサイバーセキュリティ向けの新モデルChatGPT CyberをリリースしたDaybreak Redプログラムに参加するセキュリティ専門家向けに提供され、LinuxカーネルやFirefoxで948件の脆弱性を発見したモデルのアクセス制限がセキュリティ専門家にとっての負担になっている #AIエージェント#セキュリティ
@Sarah Perez / 10日前 OpenAI、2027年にIPO可能とCEOが発言 OpenAIは2027年にIPO可能になると発表した企業向け収益が増加し、エージェントコーディング分野でAnthropicに遅れを取ったが、後半に成長を示した企業向けビジネスが収益の大部分を占めるようになり、信頼性を示すことが重要になった #AIエージェント#生成AI・LLM#クラウド
@Aisha Malik / 10日前 Claudeに「個人財務」ツールが登場 Claudeに個人の支出を分析する「Personal Finance」ツールが追加されたPlaid経由で銀行口座とクレジットカードを接続し、支出の集計やカテゴリ分け、異常な利用の検出が可能、AIが金融用語を説明する接続する口座の情報は限定的で、会話内容はモデルの学習に使われない #生成AI・LLM#AIエージェント#クラウド
@Aditya Mehta / 10日前 Axiom Mathは数学からAIの雑な出力を排除したい Axiom Mathは数学の証明を形式的に検証してAIの出力を信頼できるものにしようとしているLeanというプログラミング言語で証明をコード化し、証明補助ツールで1行ずつチェックする手法と、Stacks Projectの7654ページを1600万行のコードに変換した数学の証明を形式的に検証することで、AIが生成するコードの信頼性を高めることができる #生成AI・LLM#AIエージェント#機械学習
@Lauren Forristal / 10日前 Dropbox、Tigris Dataを3億5000万ドルで買収しAIインフラ強化 DropboxはTigris Dataを3億5000万ドルで買収しAIインフラを強化したDBX Agent Cloudにオブジェクトストレージを提供し、S3互換性とTigrisのデータ配置技術を活用買収後も従業員削減はしない方針だが、前回の9%削減はすでに実施済み #AIエージェント#クラウド#インフラ
@Stockmark Tech Blog / 10日前 AACL-IJCNLP 2026 LT4CPR Shared Task参加記 AACL-IJCNLP 2026のLT4CPR Shared Taskで1位を獲得したパイプラインによる初稿生成と双方向Brush upの2段階処理、Gemma4 31Bを使用計算コストが増えるため実用化には精度と処理時間のバランスが重要 #AIエージェント#生成AI・LLM#機械学習
@Ivan Mehta / 10日前 AinaのスマートリングはAIエージェントと会話できる AinaがAIエージェントと会話できるスマートリングを発表したマイクとジョイスティック、スクリーンを搭載し、音声でプロンプト送信やリマインダー設定が可能、Apple TVの操作もサポート価格は初期割引で399ドル、2027年1月に発送開始予定で、AIエージェントを多数運用するユーザー向け #AIエージェント#生成AI・LLM#クラウド
@Russell Brandom / 10日前 Box、NvidiaのNemotronを活用した新エージェント優先型コンテンツ検索システムを導入 BoxはNvidiaのNemotron埋め込みシステムを新機能に組み込み、エージェント優先型コンテンツ検索を実現したNemotronの埋め込みメタデータとBoxの既存メタデータ・権限制御を組み合わせ、検索精度と効率を向上Nemotronモデルは無料だが、Boxの既存メタデータと権限制御を再現するのは困難で、単純なAPIでは再現できない #生成AI・LLM#AIエージェント#RAG
@Tim Fernholz / 10日前 AI向けに5つの未解決材料科学問題に100万ドルを投じるYCスタートアップ AIが解決を目指す5つの材料科学の未解決問題に100万ドルの賞金が用意された高温超伝導の理論、シリコンと酸化シリコン界面の構造予測、熱伝導性の理論、光の影響の理論、密度関数理論の改善手法の5つが対象AIがこれらの問題を解決するには複雑な物理現象を正確に定義する必要があり、現状では進展が限定的 #AIエージェント#機械学習#生成AI・LLM
@Keita Sakashita / 10日前 AIバレを防ぐ AI生成コンテンツが受け手に「AIバレ」として感じられるケースが紹介されている網羅的で目的が不明な資料、本質からズレた画像、変な日本語の3つのパターンが挙げられている目的や本質を明確にし、Skillsを活用して自然な表現にすることが重要 #生成AI・LLM#AIエージェント#バイブコーディング
@Tim Fernholz / 10日前 Agilityは人型ロボット企業として初の上場企業に。投資家は買うか? AgilityはSPACによる上場で4億6500万ドルを調達し、人型ロボットのDigitを工業現場に展開しているDigitは繰り返し作業に特化し、9社に導入されており、Digit5は人間と安全に共存できるが、複雑な操作には未対応Digit5の導入には50万ドルの現地検証費用が必要で、生産能力は年間1万台に達する見込み #AIエージェント#バックエンド#クラウド
@nr_ishibashi / 10日前 New Relic Autopilotの応答言語を日本語に設定する方法 New Relic Autopilotの応答言語を日本語に設定できるようになったMemories機能に言語設定を保存し、Chatパネルで日本語で応答するようになる既存の言語設定を削除し、プロンプトで日本語を記録する手順が必要 #AIエージェント#クラウド#DevOps・CI/CD
@rhaya / 10日前 M365 Copilot Agent BuilderにSKILL.mdを登録してみた M365 Copilot Agent BuilderにSKILL.mdを登録してエフティーアドニャンの描画を一貫性を持たせたSKILL.mdにキャラクターの構造・色彩・表情のルールを定義し、胴体のないデザインを強制する。AIエージェントにスキルを登録して出力を安定化させるスキルの設計には細かいルール記述が必要で、トークン消費量や柔軟性の低下に注意する #AIエージェント#生成AI・LLM#DevOps・CI/CD
@petanko / 10日前 CS業務カイゼン・ジャーニー CS業務の見積もり処理をAIとバックエンドで自動化したメールの振り分けとホテル検索をAIとMCPサーバーで一気通貫処理、Google Maps APIをコンテキストに追加AIモデルに適切なコンテキストを与えることで精度向上が可能で、コストを抑えた設計が重要 #AIエージェント#バックエンド#クラウド
@分析屋 / 10日前 個人開発の定期運用タスクを自動化する構成と、半年運用して分かったこと AIエージェントを定期運用に組み込むために3つのルールを整備したドキュメントの配置ルール、ロール定義ファイルの自動適用、定期ジョブの台帳管理ドキュメントの配置ルールを事前に決めないと、AIに正しい情報を伝えるのが難しくなる #AIエージェント#DevOps・CI/CD#OSS
@taquangku / 10日前 Claude Code の CLAUDE.md / rules / skills / commands / hooks を使い分ける Claude Code で AI の振る舞いを設定する 5 種類の場所を整理したCLAUDE.md は常時、rules はパス条件、skills は手順書、commands はスラッシュコマンド、hooks は機械的強制rules の paths: は cwd 相対で、起動位置が変わるなら複数パターンを列挙する #AIエージェント#DevOps・CI/CD#アーキテクチャ
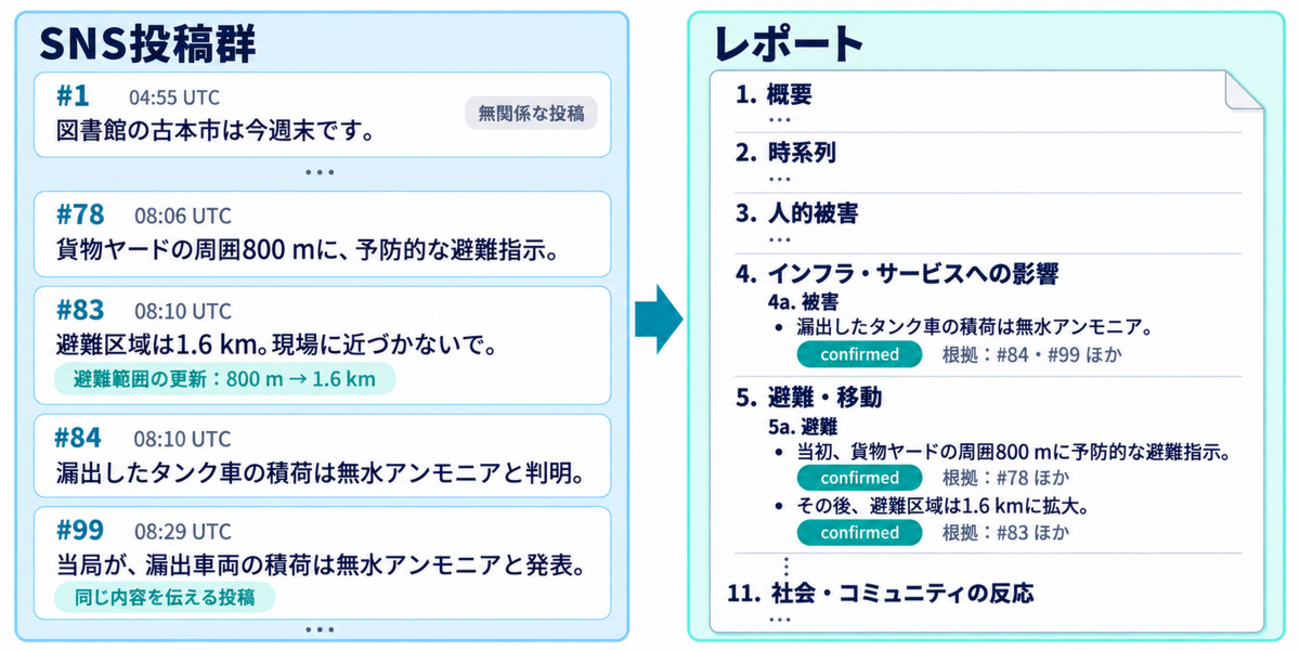
@Nishio Hibiki / 10日前 【Nishika 論文サク読み 第27回】似た形の漢字を検索するモデル Vision Transformerを用いて漢字の見た目の類似度を測るモデルが公開されたHOMOGLYPHモデルはデジタルフォントの画像で対照学習し、コサイン類似度で類似度を計算。ホモグリフ編集距離で文字列マッチングを改善日本語の辞書は約150MBで、1文字あたり800文字との類似度が保存されている #生成AI・LLM#AIエージェント#機械学習
@ma2738 / 11日前 Codexに「Claudeにレビューを頼んで」と言ったら、Claude Codeを自動起動してレビューまで完了した話 CodexがClaude Codeを直接起動し、レビューを完了したPythonのsubprocess.PopenでCLI起動、ツール制限と依頼文の禁止事項を活用実行前承認や費用管理、ソース送信先の確認が必要 #AIエージェント#バックエンド#DevOps・CI/CD
@suwa_nobu / 11日前 「人が打ったときだけ動く」はずのスキルを、AI が自分で読んだ。31万スターのスキル集を Claude Code・Codex・Gemini CLI で3回ずつ試した Claude Code・Codex・Gemini CLI で同じスキルを読み込んだ回数に違いがあったGemini CLI は印を無視し27本すべて読み込み、Claude Code と Codex は人が呼ぶ用のスキルを一覧から外すがファイルは読める副作用のあるスキルは印ではなく権限で止めることを確認、Gemini CLI は人が呼ぶ用を無効にし -p で計画モードを使わない #AIエージェント#バックエンド#DevOps・CI/CD
@Lucas Ropek / 11日前 Apple、内部AI利用の予算を削減すると報道 AppleがエンジニアチームのAI利用予算を削減したエンジニアチームのAI利用日額上限を300ドルから200ドルに、一部では100ドルに、非エンジニア部門では25ドルにAI利用コストと生産性向上のギャップが問題視されている #AIエージェント#生成AI・LLM#クラウド

 最終更新 2026/11/16 12:20