@phykm / 41日前 エントロピーの形 エントロピー関数の形状が相転移の特徴を決定するエンタルピーとエントロピーがアファイン結合で表され、体積も同様の関係を持つ。三重点ではエントロピーが一次関数になる相転移の境界ではエントロピー関数の接平面が複数の点で接し、その傾きが示強変数を示す #機械学習#バックエンド#インフラ
@nakazy / 41日前 iOS・Android実機でWebサイトを検証する iOSとAndroid実機でのWebサイト検証方法が公開されたSafari Web InspectorとChrome DevTools Remote Debuggingが主なツール、USB接続とWi-Fi接続の両方に対応実機特有の不具合を確認するにはUSB接続での初期設定が必要で、認証リセットやADBサーバー再起動で問題解決が可能 #モバイル#バックエンド#DevOps・CI/CD
@Yasuhito Morimoto / 41日前 国内AIエージェント動向(2026/8/25号) 国内AIエージェントが業務フローから事業運営へと適用範囲を広げているHmcommは1人で複数Agentで事業運営、Ownrは新規事業の作る・売る・学ぶを連続実行、クラシルは販促費管理、TIMEWELLは図面・論文処理、JPiXは投資検討支援人間の承認と例外処理、公式情報への限定、PIIマスキングなどの権限境界が明示されている #AIエージェント#機械学習#データ分析
@RyoWakabayashi / 41日前 Llamex Luna版をLivebookで動かす 〜 Nxなしの推論経路をAtomVMへ持ち込む Llamex Luna版はNxなしでAtomVMに動作する純Elixirの推論経路を実装しているBackend.AtomVMはBackend.Listに22演算を委譲し、NxとEXLAの依存を排除した構成で動作するMIX_ENV=atomvmで依存リストを空にし、PackBEAMの--pruneで不要モジュールを除外する手順が必要である #バックエンド#クラウド#DevOps・CI/CD
@yo-hirota-gxp / 41日前 「テスト自動化したいけど、何から始める?」を手探りで進めた記録 テスト自動化の実装を手探りで進めた過程を紹介Playwright MCPとPythonテストコードの使い分け、再利用可能な関数の設計、失敗時の対応ルール1ケースから始め、失敗内容をルールとして残すことで運用負荷を下げる手法が有効だった #テスト#DevOps・CI/CD#バックエンド
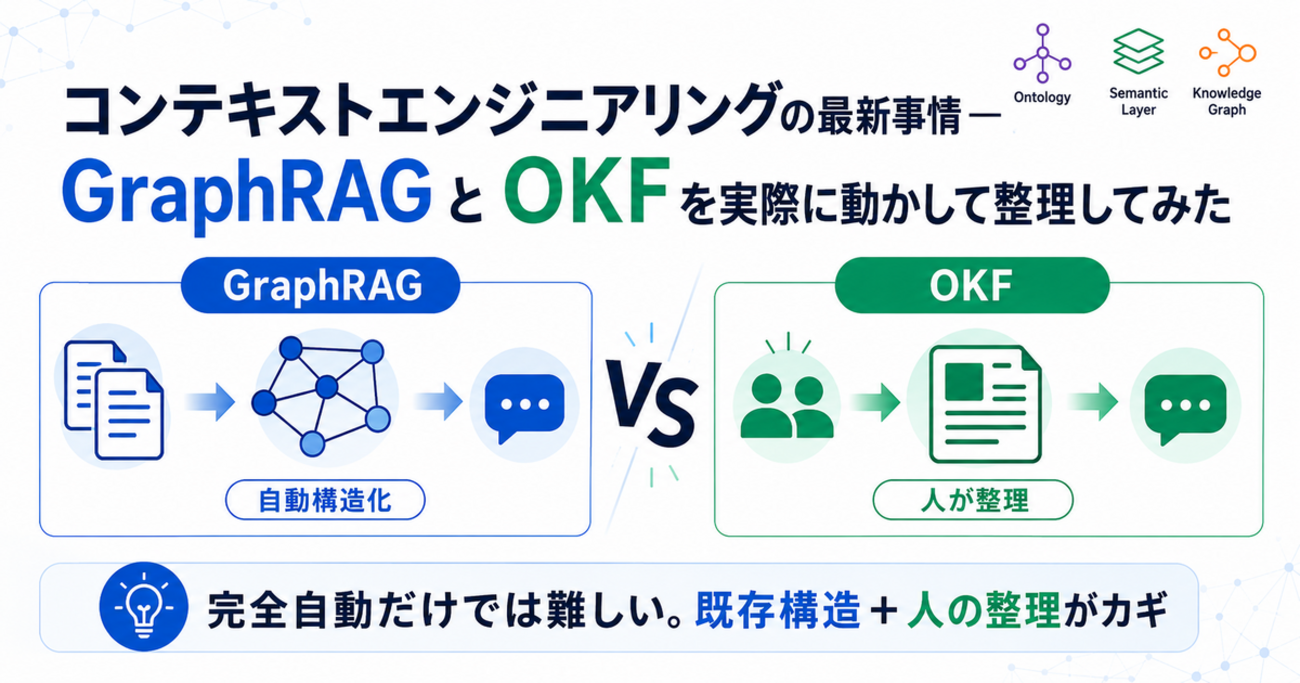
@Taste of Tech Topics / 41日前 コンテキストエンジニアリングの最新事情— GraphRAGとOKFを実際に動かして整理してみた GraphRAGとOKFの比較検証で、知識グラフの構築と管理の課題が明らかになったGraphRAGは自動抽出でノード分裂とコスト増大、OKFはシステム前提のページ名固定で概念分裂を防ぐOKFは既存システムの構造を活用するが、関係性の判断は6割未満で人間の修正が必要 #生成AI・LLM#AIエージェント#RAG
@sewiihidekikudo / 41日前 BrunoでAPIテストを自動化してみよう― Postmanのコレクションをそのままgit管理し、Cursor(AIエージェント)のターミナルでCIまで回す BrunoでPostmanのコレクションをプレーンテキストの.bruファイルで管理し、Cursorのターミナルから自動実行できる.bruファイルはGitでバージョン管理可能で、testsブロックにアサーションを記述し、bru CLIで自動実行できる.bruファイルのseq値とファイル名の連番を一致させないと実行順序が混乱するので、リネームや並び替え時はGUIで確認する必要がある #バックエンド#DevOps・CI/CD#クラウド
@nr-mito / 41日前 New Relic アップデート(2026年7月) New RelicがAutopilotとNotebookの一般提供を開始AutopilotはAIエージェントによる障害調査自動化、Notebookは変数による動的データ分析と手順書統合Autopilotは自然言語対話で障害調査を数分で完了、Notebookは変数変更で全チャート一括更新可能 #AIエージェント#RAG#クラウド
@はたはた / 41日前 SIGIR 2026 参加報告(前編) ── トップ研究者が集結する検索技術の最前線 クエリ書き換えとretriever/rerankerの組み合わせ技術が発表されたクエリ書き換えでドリフトを抑える手法、Vocabulary Transfer、LaSERによるCoT埋め込み、AgreRankによる合意アンカー拡張複数のクエリ書き換えを組み合わせる際のドリフト対策や、語彙転移の実装が導入コストに影響する #バックエンド#クラウド#インフラ
@ないとー / 41日前 減らない分岐は、指示ではなく型のせいだった 型が不正な状態を許すと、コーディングエージェントがその分岐を書く。指示を直しても減らない。判別共用体で状態を直和にし、境界でparseして型で検証する。型エラーで修正箇所を自動検出する。型が許す状態は分岐として書かれるため、レビューで確認する項目が増える。判別共用体で状態を網羅的に表現する。 #フロントエンド#バックエンド#アーキテクチャ
@jqit_suwa / 41日前 AIにテストを書かせると、決まって同じ場所が抜ける AIが生成したテスト仕様書は78件のテストケースを自作し、要件の矛盾も指摘したが、規格で測ると平均63.12%の網羅性だった同値分割(EP)のvalidのみでinvalidを抜ける、境界値分析(BVA)の下限を無視、決定表(DT)の条件を1つずつしか動かさないテストケースの網羅性は基準によって100%から25%まで変化し、同じ文書でも異なる結果になることが分かった #AIエージェント#テスト#機械学習
@ihiratch / 41日前 状態空間モデルにおけるFilteringとSmoothingの違いを理解する Filteringは過去の観測から現在の状態を推定し、Smoothingは未来の観測も使って過去の状態を推定し直すFilteringはp(x_t|y_{1:t})を計算し、Smoothingはp(x_t|y_{1:T})を計算する。予測ステップとベイズ更新、後ろ向きの尤度計算が主な手順SmoothingはFilteringより19%高い推定精度を示し、信用区間も狭くなるが、両者のアンサンブルでさらに精度向上が可能である。 #機械学習#データ分析#アーキテクチャ
@Takahiro Kume / 久米隆大 / 41日前 【AWS】Aurora MySQLのメトリクスを読み解く ― 第1回 BufferCacheHitRatioとMySQLキャッシュヒット率 Aurora MySQLのBufferCacheHitRatioはInnodb_buffer_pool_read_requestsとInnodb_buffer_pool_readsから計算されるキャッシュヒット率とほぼ一致MySQLのキャッシュヒット率はInnodb_buffer_pool_read_requestsとInnodb_buffer_pool_readsの比で算出され、AuroraのBufferCacheHitRatioも同じ計算式で求められる過渡的な負荷状態ではメトリクスに数ポイントの差が生じるが、定常状態ではほぼ一致するため、キャッシュミスの状況を反映している #クラウド#データベース#DevOps・CI/CD
@sasakuna / 41日前 敵対的検証をLLMコードレビューで試すと何が起きるのか 敵対的検証に反論役を追加したAdversarial Reviewがコードレビュー精度を3ポイント向上させるReviewerが問題点を指摘しCriticが証拠付きで反論し合意までやり取りする、AGREE/DISAGREE_EVIDENCE/DISAGREE_CONCERNの3分類トークン消費が4.5倍になるためコストと精度のバランスを考慮する必要がある #AIエージェント#生成AI・LLM#DevOps・CI/CD
@クロスマート Tech Blog / 41日前 Claude Codeのメモリ機能で、何を覚えさせて何を覚えさせないか Claude Codeのメモリ機能で、フィードバックや好みを記憶させることで作業効率を向上させるフィードバックタイプの記憶で理由まで記録し、userタイプで使い手の好みを保存する。変化する情報は現状ファイルに集約する変化する予定や進行状況はメモリに保存せず、常に現状ファイルを確認する必要がある #バックエンド#AIエージェント#DevOps・CI/CD
@Takuma Kuga / 41日前 Snowflake CoCoでdbtモデル生成を試す:自然言語・設計情報・実装ルールで何が変わるか Snowflake CoCoで自然言語や設計情報を入力した際、dbtモデルの生成結果に実装ルールが反映されるパターン③ではCTE構成や命名規則が生成コードに反映され、パターン②ではdbt設定やテスト定義がYAMLに含まれたキー項目の扱いがJOIN条件と出力項目で不一致になる可能性があり、実データとの照合が必要 #バックエンド#DevOps・CI/CD#データ分析
@kane_ryu / 41日前 PostgreSQL→Spanner移行後に248テーブルのER図(A5:SQL Mk-2)を効率的に再構築した話 PostgreSQLからCloud Spannerへの移行後、248テーブルのER図をA5:SQL Mk-2形式で効率的に再構築したgcloudコマンドのフラグ指定ミス、.a5erファイルのPosition/ZOrder設定、Pythonスクリプトによる差分マージを実施新規テーブルの配置座標を既存テーブル範囲内に設定し、リネームカラムのコメントを引き継ぐことで作業量を削減した #バックエンド#クラウド#DevOps・CI/CD
@平木 佳介 / 41日前 [社内勉強会資料公開] Claude Code 入門 #7 — プラグインとマーケットプレイスで一気に拡張する Claude Codeでプラグインを導入して機能を拡張する方法が説明されているプラグインはスキル・サブエージェント・スラッシュコマンドをまとめて配布し、マーケットプレイスからインストールする導入前に出所・中身・更新状況を確認する習慣がセキュリティ面で重要 #AIエージェント#生成AI・LLM#クラウド
@wfukatsu / 41日前 【チームによるAI駆動開発の勘所:第7回】AIに、二度、同じ指摘をしない レビュー指摘の資産化率を測る指標を定義し、還元不要の判定基準を示した資産化率は還元済み件数÷還元対象件数、還元不要には4つの理由コードが設定されている還元不要の判定にはリーダーの承認が必要で、分母の操作を防ぐための仕組みが導入されている #AIエージェント#生成AI・LLM#DevOps・CI/CD
@よさ / 41日前 TanStack Start + Hono + oRPC + Cloudflare Workersで社内ERPを作った設計と学び Cloudflare Workers上でTanStack Start + Hono + oRPC + PostgreSQLを組み合わせて社内ERPを開発した設計と学びを共有API契約と実装の分離、EVM計算の純粋関数化、Hyperdriveによるキャッシュと正しさの分離API契約を独立したパッケージにすることで、実装変更とAPI変更を明確に分離できるが、DTO定義の保守コストが増えることに注意 #フロントエンド#バックエンド#クラウド

 最終更新 2026/10/05 22:40