@YuhErus / 38日前 FIFA × Avalanche:ワールドカップのチケット販売にブロックチェーンは本当に必要なのか FIFAのワールドカップチケット販売でブロックチェーンはRTB/RTTの所有権記録に使われたRTBは権利を、RTTはチケットに変換され、ブロックチェーンで所有権履歴を記録する。データベースでも代替可能だが公開履歴が異なるブロックチェーンの主な役割は所有権の公開履歴で、チケット発行や入場管理には従来システムを使う #バックエンド#クラウド#インフラ
@tirkw / 38日前 TiDB Cloudへの移行記録 TiDB Cloudに移行する際のAUTO_INCREMENTの設定ミスやTTLの活用が説明されているMySQL互換モードのAUTO_INCREMENTで4000飛ぶ現象とTTLによる自動削除の仕組みMySQLクライアントで--commentsオプションを指定しないとTiDB固有のコメントが無視される点に注意が必要 #データベース#クラウド#DevOps・CI/CD
@nanami / 38日前 【Zenn力執筆】#9 私の記事ネタはどこから生まれるのか 記事ネタは実務・学習・体験・日常・発想起点から生まれる実務起点でAzureやHTTPステータスコード、学習起点で資格試験や検証記事を扱う記事化できないのは理解不足で、自分の言葉で説明できるようになるまで学ぶべき #キャリア#学習#チーム開発
@ONE CAREER Tech Blog / 38日前 Beyond the "Task-Driven" Internship. An IIT Student's Engineering Experience at ONE CAREER 日本でのインターンシップで日本の企業文化の誤解を打破したタスク中心から製品中心への意識の変化、言語の壁を乗り越えたコミュニケーション言語の壁や将来の不確実性を恐れず、自分を試すことを勧めている #キャリア#働き方#採用
@tkmt / 38日前 マイクロサービス間の認可伝搬をどう解くか?独自実装と IETF Transaction Tokens を見比べてみた マイクロサービス間の認可伝搬を独自実装とIETF Transaction Tokensで比較したTransaction Tokensは処理内容を含む短命JWT、Capability AssertionはリソースIDのみを含むTransaction Tokensは処理内容の改ざんを防ぐが、Capability Assertionはリソース参照に特化している #バックエンド#クラウド#インフラ
@nakazy / 38日前 iOS・Android実機でWebサイトを検証する iOSとAndroid実機でのWebサイト検証方法が公開されたSafari Web InspectorとChrome DevTools Remote Debuggingが主なツール、USB接続とWi-Fi接続の両方に対応実機特有の不具合を確認するにはUSB接続での初期設定が必要で、認証リセットやADBサーバー再起動で問題解決が可能 #モバイル#バックエンド#DevOps・CI/CD
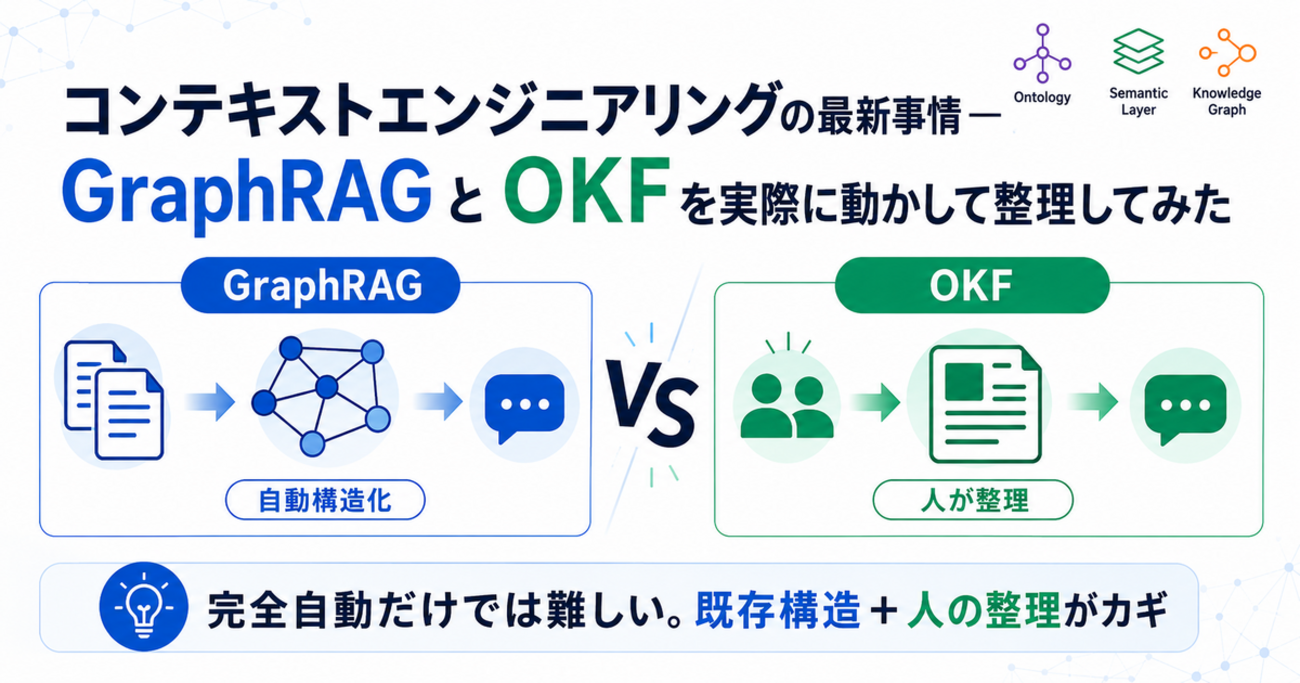
@Taste of Tech Topics / 38日前 コンテキストエンジニアリングの最新事情— GraphRAGとOKFを実際に動かして整理してみた GraphRAGとOKFの比較検証で、知識グラフの構築と管理の課題が明らかになったGraphRAGは自動抽出でノード分裂とコスト増大、OKFはシステム前提のページ名固定で概念分裂を防ぐOKFは既存システムの構造を活用するが、関係性の判断は6割未満で人間の修正が必要 #生成AI・LLM#AIエージェント#RAG
@はたはた / 38日前 SIGIR 2026 参加報告(前編) ── トップ研究者が集結する検索技術の最前線 クエリ書き換えとretriever/rerankerの組み合わせ技術が発表されたクエリ書き換えでドリフトを抑える手法、Vocabulary Transfer、LaSERによるCoT埋め込み、AgreRankによる合意アンカー拡張複数のクエリ書き換えを組み合わせる際のドリフト対策や、語彙転移の実装が導入コストに影響する #バックエンド#クラウド#インフラ
@ないとー / 38日前 減らない分岐は、指示ではなく型のせいだった 型が不正な状態を許すと、コーディングエージェントがその分岐を書く。指示を直しても減らない。判別共用体で状態を直和にし、境界でparseして型で検証する。型エラーで修正箇所を自動検出する。型が許す状態は分岐として書かれるため、レビューで確認する項目が増える。判別共用体で状態を網羅的に表現する。 #フロントエンド#バックエンド#アーキテクチャ
@Takahiro Kume / 久米隆大 / 38日前 【AWS】Aurora MySQLのメトリクスを読み解く ― 第1回 BufferCacheHitRatioとMySQLキャッシュヒット率 Aurora MySQLのBufferCacheHitRatioはInnodb_buffer_pool_read_requestsとInnodb_buffer_pool_readsから計算されるキャッシュヒット率とほぼ一致MySQLのキャッシュヒット率はInnodb_buffer_pool_read_requestsとInnodb_buffer_pool_readsの比で算出され、AuroraのBufferCacheHitRatioも同じ計算式で求められる過渡的な負荷状態ではメトリクスに数ポイントの差が生じるが、定常状態ではほぼ一致するため、キャッシュミスの状況を反映している #クラウド#データベース#DevOps・CI/CD
@クロスマート Tech Blog / 38日前 Claude Codeのメモリ機能で、何を覚えさせて何を覚えさせないか Claude Codeのメモリ機能で、フィードバックや好みを記憶させることで作業効率を向上させるフィードバックタイプの記憶で理由まで記録し、userタイプで使い手の好みを保存する。変化する情報は現状ファイルに集約する変化する予定や進行状況はメモリに保存せず、常に現状ファイルを確認する必要がある #バックエンド#AIエージェント#DevOps・CI/CD
@Takuma Kuga / 38日前 Snowflake CoCoでdbtモデル生成を試す:自然言語・設計情報・実装ルールで何が変わるか Snowflake CoCoで自然言語や設計情報を入力した際、dbtモデルの生成結果に実装ルールが反映されるパターン③ではCTE構成や命名規則が生成コードに反映され、パターン②ではdbt設定やテスト定義がYAMLに含まれたキー項目の扱いがJOIN条件と出力項目で不一致になる可能性があり、実データとの照合が必要 #バックエンド#DevOps・CI/CD#データ分析
@平木 佳介 / 38日前 [社内勉強会資料公開] Claude Code 入門 #7 — プラグインとマーケットプレイスで一気に拡張する Claude Codeでプラグインを導入して機能を拡張する方法が説明されているプラグインはスキル・サブエージェント・スラッシュコマンドをまとめて配布し、マーケットプレイスからインストールする導入前に出所・中身・更新状況を確認する習慣がセキュリティ面で重要 #AIエージェント#生成AI・LLM#クラウド
@wfukatsu / 38日前 【チームによるAI駆動開発の勘所:第7回】AIに、二度、同じ指摘をしない レビュー指摘の資産化率を測る指標を定義し、還元不要の判定基準を示した資産化率は還元済み件数÷還元対象件数、還元不要には4つの理由コードが設定されている還元不要の判定にはリーダーの承認が必要で、分母の操作を防ぐための仕組みが導入されている #AIエージェント#生成AI・LLM#DevOps・CI/CD
@KAKEHASHI Tech Blog / 38日前 ユーザーからSREとして「中の人」へ、薬局での体験から繋がるカケハシの開発者体験 カケハシではオンボーディングが充実し、1on1の文化やカンファレンス支援制度が特徴的オンボーディングコンテンツが豊富で、SSOやIaC化が整っており、隣のチームとの1on1やカンファレンス参加を支援する制度がある社内でのコミュニケーションやスキルアップの機会が豊富で、生成AIを活用した開発が推進されている #キャリア#マネジメント#チーム開発
@nishikawa / 38日前 AI 時代の WAF の重要性を考えてみている AI時代においてWAFの重要性が再評価されている大量の脆弱性公開によりトリアージが遅れ、基本的なSQLi/XSS/RCE対策のWAFルールが重要になるベンダーの脆弱性対応遅延により無防備期間が長くなるため、基本的なWAFルールを導入するべきだ #セキュリティ#AIエージェント#インフラ
@せとぅ / 38日前 Fabric Warehouse の queryinsights でクエリを監視&分析する Fabric Warehouseのqueryinsightsでクエリ履歴と集計情報をT-SQLから参照できるexec_requests_historyとlong_running_queriesなどのビューで履歴と集計を確認、クエリ形状単位の集計が可能クエリ形状が同じ場合はフィルター条件に関係なく同一クエリとして扱うため、傾向分析に適している #バックエンド#クラウド#データベース
@カミナシ エンジニアブログ / 38日前 SaaSの技術的難しさはホリゾンタルとバーティカルで異なる SaaSの技術的難しさはホリゾンタルとバーティカルで戦い方が異なるホリゾンタルは95点の答えを高速に実装し、バーティカルは30点の解を70点に高めるテーマごとに90点か70点かを判断し、品質水準や検証プロセスを変える必要がある #バックエンド#アーキテクチャ#プロダクト開発
@HERP TechHub / 38日前 TCP エコーサーバで理解する readiness-based と completion-based readiness-basedはepollで、completion-basedはio_uringで実装されるTCPエコーサーバの設計パターンが説明されているreadiness-basedはイベント通知を待ってからI/O処理を実行し、completion-basedは非同期処理でカーネルに依頼して完了を確認するreadiness-basedではイベント発生を待ってから処理を実行し、completion-basedでは処理完了を確認してから次の処理に進む仕組みが異なることが重要 #バックエンド#クラウド#インフラ
@takekawa tomoki / 39日前 Azure API Management - On-Behalf-Of フローを組み、AI Search をユーザー権限で検索する Azure API Managementを経由してユーザー権限でAI Searchを検索する仕組みを構築APIMでOAuth 2.0のOn-Behalf-Ofフローを実装し、マネージドIDとアプリ登録でトークンを交換ユーザー単位のアクセス制御と監査が可能になるため、権限管理が重要なシステムで有効 #クラウド#バックエンド#セキュリティ

 最終更新 2026/10/02 20:40