@higu / 1日前 AWSしか触ってこなかった私が、GCPで手が止まった話(前編:IAM・CI/CD・GKE) GCPのIAMではAWSとは異なる文法で許可を書くAWSは条件式、GCPは名簿への登録で許可を設定し、CI/CDでは認証JSONを手動で組むGCPのService Account名は6〜30文字の制約があり、削除後30日間は同じ名前を使えない #バックエンド#クラウド#DevOps・CI/CD
@ビジハックマスター|会社員の「壁」攻略本 / 1日前 【無料】【号外】ChatGPTに“AI社員”がついに来た。24時間勝手に働くOpenAI「dots」とは? OpenAIが「dots」という24時間働くAIエージェントを発表したGPT-6 Astraを頭脳に使い、4,000以上のアプリと接続できるクラウドコンピューターを持つユーザーが設定したルール内で勝手に作業し、重要な操作は人間の承認が必要 #AIエージェント#生成AI・LLM#クラウド
@Hiromu Ogawa / 1日前 BigQuery 会話分析 データエージェント超入門【利用編】 BigQueryデータエージェントは検証済みクエリと指示を元に質問に回答し、予測機能は設定によって制限される検証済みクエリが使われた場合は「Verified Query」表示、予測機能は指示で断る設定が可能、データポータルからアクセスする際の権限設定が必要予測結果の信頼性を確認するにはSQLと実績データを照合し、データポータルでのアクセスにはIAM権限とプロジェクト設定が必要 #クラウド#バックエンド#データ分析
@Kazuki Odo / 1日前 Full-Managed のその奥は? FSx for Lustre の I/O 問題を AWS と一緒に切り分ける FSx for LustreのI/O問題をAWSと共同で切り分け、TCP化で対応した通信経路の障害、メタデータロック競合、特定OSTでのI/O停止が原因。EFA経路の再送エラーとTCPへの切り替えが対応手段AWSのサービス変更やソフトウェア更新で挙動が変わる可能性があるため、公式ドキュメントを確認し環境で検証すること #クラウド#インフラ#DevOps・CI/CD
@t_ushizawa / 1日前 VSCode + Session Manager + DevContainerで構築するAIエージェント向けAWS開発環境 VSCode + Session Manager + DevContainer + BedrockでAWS上にAIエージェント向け開発環境を構築可能Session ManagerでSSH公開せず接続、DevContainerで環境標準化、Bedrock経由でIAMロール認証アクセスキーを配布せずIAMロールで認証できるためセキュリティが向上し、オフラインでも作業可能 #AIエージェント#クラウド#DevOps・CI/CD
@fuji333 / 1日前 Bitbucket PipelinesとCodePipelineを活用したECS(Fargate)自動デプロイ環境の構築 Bitbucket PipelinesとCodePipelineを組み合わせてECS(Fargate)への自動デプロイを実現したOIDCによるセキュアなAWS連携とECRへのイメージプッシュ、EventBridgeとCodePipelineによるFargateへのローリングアップデートデプロイの時間的・金銭的コストが予想以上にかかることを確認し、キャッシュ最適化やライフサイクルポリシーの設定が必要 #クラウド#DevOps・CI/CD#インフラ
@CHEN CHEN / 1日前 OpenAI Agents API を試す:GitHub の OSS を一言で使わせてみた OpenAI Agents API は、エージェントをサンドボックスで実行するためのAPIとして公開されたエージェントの自律的な作業と実行環境の管理をOpenAIが担当、GitHubのOSSをインストールしてPDFをMarkdownに変換したデータ保存先は米国のみでZDRには対応していないため、社外秘のファイルを扱う際は注意が必要 #AIエージェント#生成AI・LLM#クラウド
@CHEN CHEN / 1日前 GPT Image 2.5 と GPT Image 2 の日本語スライド生成を比較検証 GPT Image 2.5 は GPT Image 2 と比べてコストと生成時間が大幅に改善されているコストは1/4、生成時間は3.8倍〜2.6倍速く、flare と sunburst の2モデルが存在品質を high に設定した場合、GPT Image 2.5 は GPT Image 2 よりも安定性が向上している #生成AI・LLM#AIエージェント#クラウド
@Hiromu Ogawa / 1日前 BigQuery 会話分析 データエージェント超入門【作成編】 BigQueryでデータエージェントを作成し、自然言語でクエリを実行できるように設定知識源にテーブルを指定し、用語集と検証済みクエリで回答の定義を明確化、実行制限を設定データエージェントの利用にはBigQueryの読み取り権限とクエリ実行権限が必要で、費用はクエリ量に応じて発生 #クラウド#バックエンド#データ分析
@Yasuhito Morimoto / 1日前 国内AIエージェント動向(2026/9/30号) 国内のAIエージェントが企業データを直接参照し、分析・記録・改善提案・業務実行まで担う仕組みへ移行ヘッドウォータースの「Silverデータ」基盤、WAPの「AquaAgent」統合基盤、NVIDIAの安全基盤が登場企業データを直接扱うAIエージェントの導入にはACL・認証・監査ログの標準化が重要になる #AIエージェント#クラウド#インフラ
@kyuko / 1日前 【Pyunto Robotics】そろそろフィジカルAIの時代に備えて、スマホからロボットを呼び出そう! Pyunto Roboticsというライブラリが公開され、スマホからロボットを操作できるようになったPyunto Roboticsは日記型メッセージングアプリからロボットを操作するためのライブラリで、Gemma 4でロボットの判断を実行するPython 3.13以降ではロボットが文章を読む機能が使えないため注意が必要 #AIエージェント#バックエンド#クラウド
@もちあんこ / 1日前 e-Gov の様式改定に備えて、申請様式の「版」を管理できるようにした話 申請様式の「版」をカタログ・トラック・版で管理する仕組みを設計したカタログで様式の種類、トラックで会社ごとの独自設定、版で日付による切り替えを分離した手続き開始時に選んだ版を保存し、送信前にその版が有効か再確認する仕組みを導入した #バックエンド#クラウド#DevOps・CI/CD
@nakata_yusuke / 1日前 RenderGraphのメモリ帯域削減 ― SoCのメモリ階層から実機計測まで RenderGraphでメモリ帯域を削減するためのLoad/Store ActionとNativeRenderPassの実装方法が説明されているLoad ActionのClearとDontCare、Store ActionのDontCareとStore、NativeRenderPassによるパスマージが具体的に記載されているRenderGraph ViewerでLoad/Store Actionの状態を確認し、実機でXcodeのプロファイラーでメモリ帯域の削減効果を測定する必要がある #フロントエンド#バックエンド#クラウド
@NttData Abe / 1日前 ローカルでコーディングエージェント構築(Ollama + hermes Desktop) OllamaとHermes Desktopでローカルのコーディングエージェントを構築する方法が説明されているOllamaでローカルLLMを設定し、Hermes Desktopでコーディングエージェントを構築する。モデルにはqwen3.6:35bやgemma4:26bが挙げられるモデルのコンテキスト長やシステムプロンプトを設定する必要があり、一部のモデルではファイル生成や会話の継続ができない #AIエージェント#バックエンド#クラウド
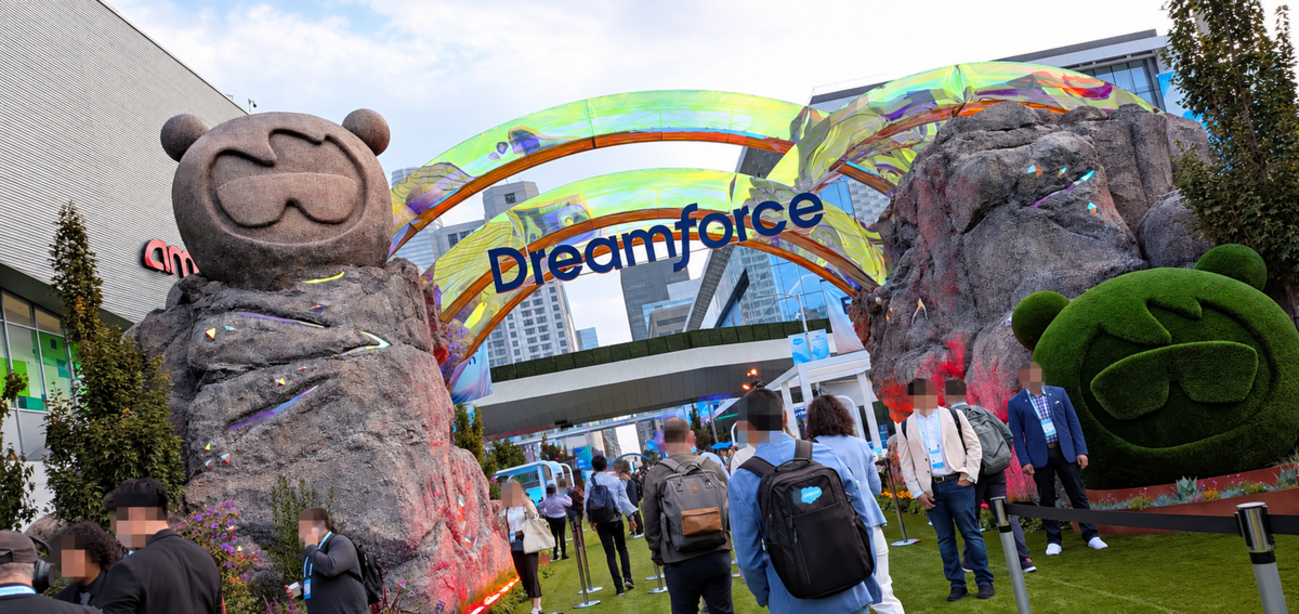
@Sodech Developer Blog / 1日前 【Salesforce】Dreamforce2026参加レポート SalesforceがDreamforce2026でAI時代の業務変化を紹介し、Revenue Cloudのバイブコーディング設定とOptimize & ObserveのAI監視機能を発表Revenue Cloudの管理者向け設定をバイブコーディングで実行可能、Optimize & ObserveでAI利用状況をグラフ化して改善に活用AI利用量に応じたコストが発生するため、運用時の費用管理が重要で、AIの後輩を指導する先輩としてのスキルが必要 #バイブコーディング#AIエージェント#クラウド
@分析屋 / 1日前 Snowflake TaskでPower BI用データマート更新を自動化した実務事例 SnowflakeのTask機能でPower BI用データマートの更新を自動化したストアドプロシージャによる差分更新と、スケジュール実行の設定Taskの監視とエラー時の復旧手順を実務で確認する必要がある #クラウド#データベース#DevOps・CI/CD
@manrikitada / 1日前 RevenueCat導入しても自社DB権限管理を守り切りたいときの設計 RevenueCatを導入しても自社DBで権限を管理するための決済ロジックを設計した決済前インテント記録、同期パスでの即時権限付与、Webhookによる検算と復旧、日次取引データ突合の4つの工夫を採用取引IDを単独でコミットして復旧の起点を残し、Webhookは検算と復旧に利用する #バックエンド#クラウド#DevOps・CI/CD
@Yosuke Kodama / 1日前 Snowflakeのデータからダッシュボードを作る — 対話型BI「Squadbase」を実際に試してみた SquadbaseはSnowflakeに接続し、自然言語でダッシュボードを作成・変更できるSnowflake接続設定と自然言語によるグラフ変更、生成されたSQLの確認が可能生成されたSQLとコードを確認する必要があり、集計ロジックの検証に技術知識が必要 #クラウド#AIエージェント#フロントエンド
@Chengkai Yan / 1日前 SAP BDCナレッジ集:Delta SharingでDatasphereとSAP Databricksをつなぐ SAP Datasphereに登録したCSVデータをDelta SharingでSAP Databricksに共有する方法を紹介Data Product作成とDelta Sharing経由の共有、Local Table (File)の作成が主な手順SAP Databricksから直接参照できる状態にするにはSAP DatasphereでのData Product準備が必要 #クラウド#データ分析#インフラ
@Takahiro Kume / 久米隆大 / 1日前 【AWS】Aurora MySQLのメトリクスを読み解く ― 第2回 パージ処理関連のメトリクス Aurora MySQLのInnoDBパージ処理に関連するCloudWatchメトリクスを検証したRollbackSegmentHistoryListLength、PurgeBoundary、PurgeFinishedPoint、TruncateFinishedPointの4つのメトリクスを確認し、長時間トランザクションがパージ処理をブロックすることを実証した長時間トランザクションがあるとPurgeBoundaryが進まず、パージが遅延するため、トランザクションの管理が重要になる #クラウド#データベース#DevOps・CI/CD

 最終更新 2026/10/01 18:20