@nttdata-ccs-techblog / 2日前 「この余白を2mmに」で直るチラシデザイン。Claude Codeと入稿まで。 紙のチラシをClaude CodeとオープンソースのDTPソフトDesignCraftで組み、Illustratorで仕上げて入稿したDesignCraftで組版を操作させ、印刷所の規定をPythonで検査し、Illustratorで仕上げの作業をした印刷所の総インク量300%未満などの細かい規定はPythonで検査し、入稿前に確認できる #フロントエンド#バックエンド#クラウド
@分析屋 / 2日前 GA4のBigQueryエクスポート入門 ― スキーマの構造と、つまずきやすい4つのポイント GA4の生イベントデータをBigQueryにエクスポートする際、イベントパラメータはkeyと型別カラムを持つ繰り返しフィールドで、日付別シャーディングされたテーブルを扱うUNNESTでパラメータを取り出し、_TABLE_SUFFIXで期間指定し、スキャン量課金を意識したクエリを書くSELECT *と期間無指定の組み合わせはスキャン量が膨らむため、_TABLE_SUFFIXでの絞り込みと必要なカラムだけを選択する習慣をつける #クラウド#データベース#DevOps・CI/CD
@GS2 Blog / 2日前 GS2-Account に有効期限つきの引き継ぎコードを追加しました GS2-Accountに有効期限つきの引き継ぎコード機能を追加したコードの有効期限設定、失敗回数制限、使用後の削除が可能で、ユーザーIDとパスワードの自動管理が可能ゲーム開発者はコードの期限管理やセキュリティ対策を自前で用意する必要がなくなった #バックエンド#クラウド#セキュリティ
@r-jw / 2日前 バックアップ HDD の「静かな死」を防ぐ仕組み ― smartctl でヘルスチェック HDDの静かな死を防ぐためにsmartctlで毎晩ヘルスチェックを実施毎晩smartctl -xでSMART属性を比較し、月1回拡張セルフテストで全セクタを読むHDDの代替待ちセクタ数や温度の増加、セルフテストの失敗を監視する #バックエンド#クラウド#インフラ
@Tatsu / 2日前 dbt のメタデータを Knowledge Catalog (Dataplex) に取り込む Google Cloud Knowledge CatalogにdbtのメタデータをGAで取り込めるようになった技術メタデータ・ビジネスメタデータ・オペレーションメタデータ・リネージメタデータ・使用状況メタデータが対象、エントリタイプとアスペクトタイプはGoogle管理dbtのアーティファクトをGCSにアップロードしてメタデータジョブを作成する必要があり、--aspects-onlyで定期更新時はリンク更新がされない #クラウド#データ分析#DevOps・CI/CD
@平木 佳介 / 2日前 ARTEX・AntiFox の事例から、AI ペネトレーションテストツールの悪用と AWS の対策をまとめてみた AIペネトレーションテストツールの自動化範囲が判断まで広がり、ARTEXとAntiFoxが実際の攻撃に使われているAIエージェントが実行結果を読み次の操作を判断する仕組み、認証情報漏洩や権限過大が主な攻撃対象認証情報の届く範囲を狭め、拒否と成功を合わせて監視し、リスクに応じた対応時間を決めることが重要 #セキュリティ#クラウド#AIエージェント
@metappi / 2日前 本番(prod)サーバーに自動処理を組んだのでまとめ 本番サーバーに予約公開やAI審査の自動処理環境を構築したcronとLaravelスケジューラで定期実行、キューとワーカーで非同期処理、Supervisorで常駐管理ワーカーの再起動はSupervisorに任せても処理結果の確認は別途必要で、同じジョブの重複実行リスクを考慮した設定が必要 #バックエンド#DevOps・CI/CD#クラウド
@赤帽エンジニアブログ / 2日前 RamaLamaを使ってコンテナ環境でAIモデルをローカル実行する RamaLamaはコンテナでAIモデルをローカルで実行できるOSSのCLIツールとして公開されたGPUやCPUの環境に応じてコンテナイメージを自動選択し、llama.cppやvLLMなどのランタイムでモデルを実行するHugging FaceやOCIレジストリからモデルを取得し、ローカルに保存して再利用できる #AIエージェント#バックエンド#クラウド
@クラウドエース株式会社 / 2日前 【図解】Google Cloud FinOps ハブとは?基礎知識とコスト最適化のファーストステップ Google CloudのFinOpsハブがコスト最適化の健康診断ツールとして提供されているFinOpsスコアと推奨事項、CUDの活用が主な機能で、無駄なリソースの可視化と削減が可能FinOpsスコアは2日前のデータをもとに毎日更新され、反映には数日かかるため定期的な確認が必要 #クラウド#インフラ#DevOps・CI/CD
@autonomura / 2日前 QuarkusのCycloneDX ExtensionでSBOMを生成・埋め込み、実行中のアプリから取得してみた QuarkusのCycloneDX ExtensionでSBOMを生成・埋め込み、実行中のアプリから取得できるDistribution SBOMとDependency SBOMの2種類を生成し、実行時とビルド時の依存関係を含むコンポーネント情報を取得可能SBOMは/.well-known/sbomエンドポイントからREST APIで取得可能で、ライセンス情報や脆弱性調査に利用できる #バックエンド#クラウド#DevOps・CI/CD
@ktdatascience / 2日前 AWS SAAに737点で合格。Udemyの講座を流し見して、模擬試験に集中した話 AWS SAA試験で737点を取得し、Udemyの動画講座と模擬試験を主に使った動画講座は全体像を把握し、模擬試験は問題演習に重点を置いた。サービスの役割の違いを意識して整理した間違えた問題をAIで確認し、公式ドキュメントで再確認する習慣をつけることが重要だった #クラウド#DevOps・CI/CD#テスト
@ihiratch / 3日前 仕組み編:Two-Towerによる検索システム(学習・推論・配信) Two-Towerモデルはクエリとアイテムを別々のニューラルネットワークでベクトルに変換し、類似度で関連度を評価するクエリタワーとアイテムタワーの内積でスコアを計算し、バッチ内負例とMNSによる負例サンプリングで学習する人気アイテムのバイアスを補正するlogQ補正と、ANNによる高速検索が実装時の注意点 #機械学習#バックエンド#クラウド
@yyoshida15 / 3日前 CRA報告対応② Dependency-Trackで脆弱性の検知を自動化する(Pleasanter連携) Dependency-Track v5.2で脆弱性情報源を自動収集し、SlackとPleasanterに連携してCRA報告を自動化した6つの情報源(GitHub Advisories・OSV・JVN iPedia・NVD・KEV・EPSS)を毎日取り込み、Webhookと中継サーバーでPleasanterに自動登録、Slackで即時通知と毎朝のまとめを送信NVDのフィードが途中で切れる問題と、JVN由来の検出が誤検知になる可能性、KEV掲載の脆弱性が後から通知されない点に注意が必要 #DevOps・CI/CD#セキュリティ#クラウド
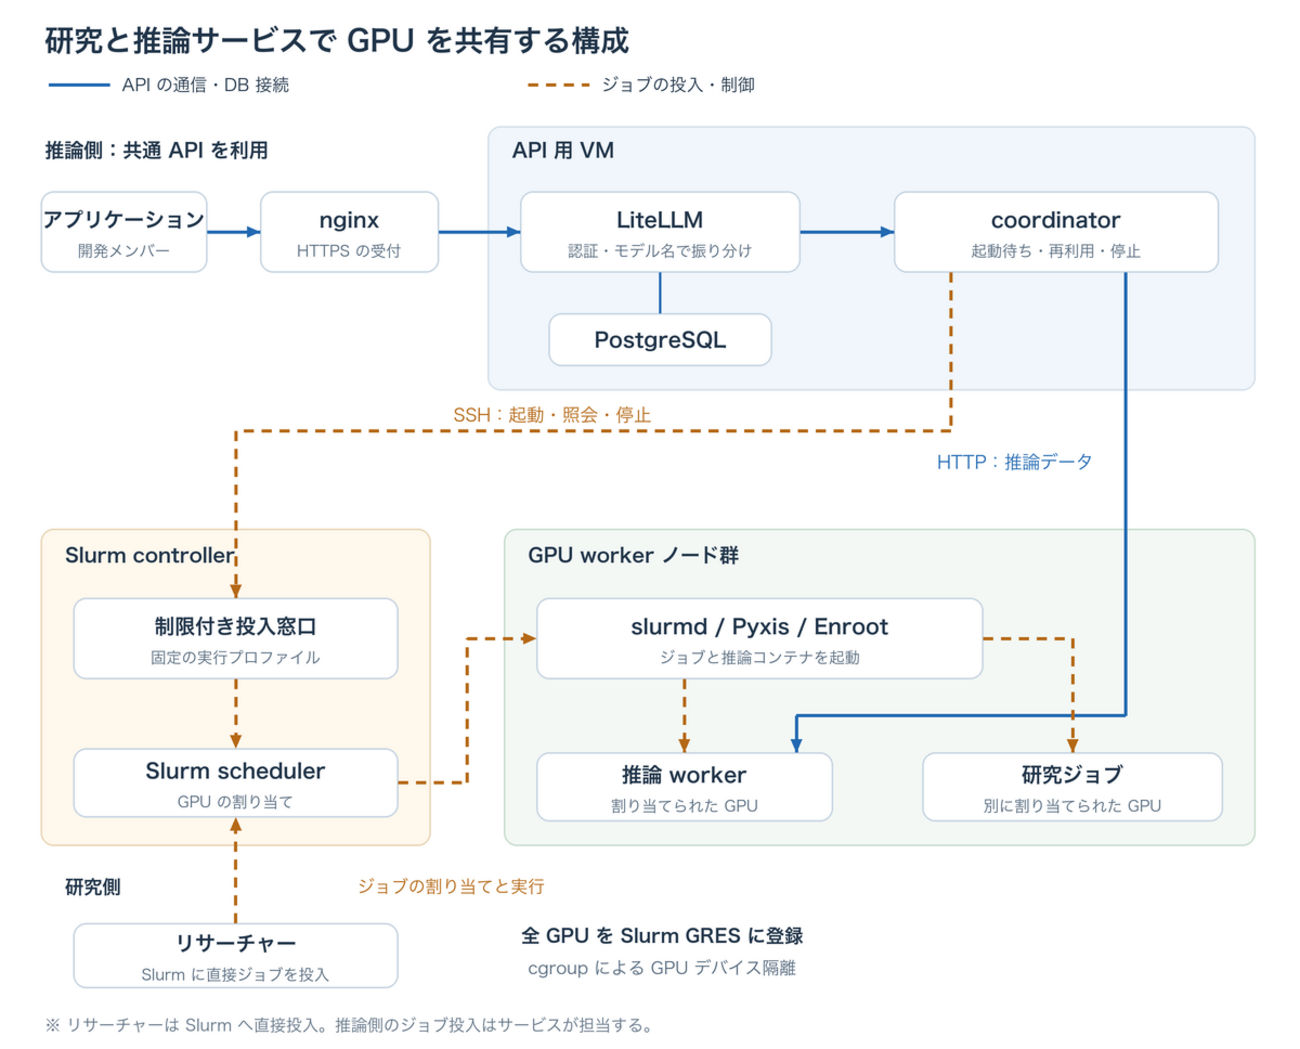
@Stockmark Tech Blog / 3日前 Slurmによる研究と推論サービスのGPU共有 Slurmで研究と推論のGPUを共有する仕組みを構築常駐サービスはSlurmのreservationでGPUを確保、オンデマンドサービスは空きGPUを即時要求、GPUのデバイス隔離にcgroupを使うオンデマンドサービスはGPU不足時に失敗する可能性があるため、常駐サービスへの切り替えをアプリケーション側で判断する #バックエンド#クラウド#DevOps・CI/CD
@Takashi_Masumori / 3日前 Copilot in SharePoint で、リストとライブラリの作成はどこまで楽になったか試してみた Copilot in SharePoint でリストとライブラリの作成が効率化されたスキルで列名を英語に、表示名を日本語に変更、オートフィル列でメタデータを自動入力オートフィルの処理には1時間程度かかるため、リアルタイム性が必要な場合は注意 #フロントエンド#バックエンド#クラウド
@takumi_engineer / 3日前 引き継ぎ先不明の社内システムの証明書期限をPython標準ライブラリで棚卸しする Python標準ライブラリでホスト名の証明書期限を一括で確認するスクリプトが公開されたDNS解決とTLS証明書の期限をsslモジュールとsocketモジュールで処理、CSV出力で一覧化社内CAの証明書は検証を無効化せずルート証明書を読み込むことで対応する #バックエンド#クラウド#DevOps・CI/CD
@ki_ka / 3日前 Muse の Spaces でオークションサイトの出品監視ツールを作ってみた MuseのSpacesでオークションサイトの出品監視ツールを作成したMuseのブラウザ操作機能とSpacesのカスタム画面で出品情報を収集・監視、自動タスクで定期的に更新リアルタイム更新は制約があり、1時間ごとの巡回で動作確認が必要 #AIエージェント#クラウド#DevOps・CI/CD
@shinonomelon / 3日前 Raycast の Slack 拡張「Slack Compass」を作った Slack Compassという自作拡張でSlackのメッセージ検索と返信を1つの画面で行えるようにした検索画面でチャンネル開く・メッセージを探す・返信する・リアクションを付ける機能を統合し、Slack APIに直接問い合わせるのではなくキャッシュを使用Slackのユーザートークンが必要で、トークンは他人に渡さず不要時は削除する #フロントエンド#バックエンド#クラウド
@iizuka kota / 3日前 最強オープンウェイトモデル Kimi-K3.1-Pro をセルフホストして独自ベンチで比べてみた Kimi-K3.1-Pro がオープンウェイトモデルで最強とされる理由を、推論速度と賢さのベンチマークで検証推論速度では K3.1-Pro が K3 よりも高速で、賢さのベンチでは 10 モデル中 1 位を獲得K3.1-Pro のデプロイには vLLM Recipes と KV キャッシュの調整が重要で、並列度に応じた性能変化に注意が必要 #生成AI・LLM#AIエージェント#クラウド
@Hayashi / ホロラボ / 3日前 大容量データのアップロードを止めるな:tusによる再開できるアップロード tusプロトコルとtusd、Uppyを組み合わせて大容量データの再開可能アップロードを実現tusはHTTP上で再開可能なアップロードを可能にし、tusdはメモリ使用量を抑えてファイルを直接ディスクに書き込み、Uppyはブラウザ側でフォルダ選択とドラッグ&ドロップに対応IISを使用する場合はチャンクサイズの指定とX-Forwarded-*ヘッダーの設定が必要で、通信断時の挙動はクライアント側とサーバー側で異なる #バックエンド#クラウド#DevOps・CI/CD

 最終更新 2026/11/16 11:31