@はこいぬ / 58日前 ローカルJevの可能性検証 Gemmaをベースにした3つの構成でJev風の判断モデルを実装し、日本語の3択分類タスクで比較した案Aはトークンスコアから確率を計算、案Bは分類ヘッドを追加、案Cは共有採点ヘッドで候補を評価LoRAによる追加学習で正答率が8割を超え、生成不要の構成でも高速な推論が可能だった #生成AI・LLM#機械学習#DevOps・CI/CD
@harupython / 58日前 LLMの代わりになる? 文章を生成しないAI「Jev」を日本語で試してみた 文章を生成しないAI「Jev」は、判断と確率を返すモデルで、LLMとは異なる出力方式を持つChoice・Score・Noulの3種類の返り値形式、LLMのStructured Outputsとの出力方式の違いJevは文章生成せず判断と確率を返すため、処理に応じた使い分けが重要で、実際の性能は入力内容に依存する #生成AI・LLM#AIエージェント#機械学習
@dahatake / 58日前 AI コーディングエージェントの1タスクが8時間かかる理由を、45日分のセッション履歴から測ってみた AIコーディングエージェントの1タスクが8時間かかる理由は、文脈の積み上げと指示の不備が主因コンテキストサイズが100kトークンを超えると遅延が10倍に、検証スキルのロード不足と指示の無限スコープが原因指示に完了条件と時間上限を明記しないと1指示で200回以上のモデル呼び出しと400分以上の時間がかかる #生成AI・LLM#AIエージェント#機械学習
@Yasuhito Morimoto / 58日前 「話さないAI」Jevは何が違う? LLMと組み合わせて考える、効率化とコスト削減 Jevはソフトウェアに組み込む「判断係」のAIモデルで、問い合わせを分類するChoice・Score・Noulの3つの判断機能があり、出力は無料で入力単価が低いJevの入力単価はTerraの約48分の1で、出力無料の課金方式がコスト削減に繋がる #生成AI・LLM#AIエージェント#機械学習
@MOBILUS TECH BLOG / 58日前 TypeSafe AI - 現時点でわかっていることまとめ TypeSafe AIが新しいモデルJevを発表し、チャット機能を持たない判定AIとして機能するchoiceやscore、noulといった選択肢やスコアの判定機能と、確率の較正が特徴応答速度が高速で価格が安く、ビジネス用途に適しているがチャット機能がないため制限がある #生成AI・LLM#AIエージェント#機械学習
@shinkai_ / 58日前 「LLMじゃないAI」が来た! TypeSafe AI「Jev」はなぜ文字列生成を捨てたのか TypeSafe AIがLLMではないSystem One Modelsを発表、第一弾はJev並列サンプラーと型付き構造化出力、RLCDという独自の強化学習手法を採用出力コストが無料で応答時間が数十〜数百倍速いが、自由な文章生成は不可 #生成AI・LLM#AIエージェント#機械学習
@Phung Dinh Son / 58日前 Markdownは新しい攻撃ベクトルになった — AIエージェント時代の間接プロンプトインジェクション入門 プロンプトインジェクションはLLMの構造的制約であり、間接インジェクションが特に危険プロンプトインジェクションの2種類(直接・間接)、Lethal Trifecta(プライベートデータ・信頼不能コンテンツ・外部通信の3要素)プライベートデータへのアクセスを最小限にし、信頼不能コンテンツを厳しくチェックし、外部通信を制限する対策が有効 #AIエージェント#機械学習#セキュリティ
@Tamura Satoru / 58日前 AIペルソナはユーザーの代わりになるのか? 論文3本から探る、できること・できないこと LLMはUIの問題候補を挙げたり、人間と重なる定性的な論点を出したりできるDuan et al.はGPT-4でUIガイドライン違反を検出、Hwang and KangはAIペルソナで定性的テーマを抽出、Kuric et al.はGPTのクリック行動を実ユーザーと比較LLMの出力は実ユーザーの反応そのものではなく、仮説や予測として扱う必要がある #生成AI・LLM#AIエージェント#機械学習
@yushibats / 58日前 話題のJevとは?文章を書かずに判断だけを返すAIモデルをざっくり解説 Jevは文章を生成せず、選択肢ごとの確率と確信度を返すAIモデル選択肢から1つ選ぶChoice、段階評価のScore、Yes/NoのNoulの3種類の問いに対応。確信度で処理を分岐可能確信度が0.9以上なら自動処理、0.5以上なら人間確認、それ以下なら人が振り分け。計算や日付比較は不得意と明記 #生成AI・LLM#AIエージェント#機械学習
@aidasquid / 59日前 2026年版 LLM勢力図&モデルまとめ 2026年現在のLLM勢力図と主要モデルの特徴がまとめられているChatGPT、Claude、Gemini、DeepSeek、Qwen、Moonshot、Liquid AI、xLSTM、Jevなどのモデルと、Transformerの代替アーキテクチャが紹介されているLLMの性能やアーキテクチャの選択が開発戦略に直接影響するため、モデルの特徴を理解することが重要 #生成AI・LLM#AIエージェント#機械学習
@Yasuhito Morimoto / 59日前 国内AIエージェント動向(2026/9/18号) 国内のAIエージェント導入が業務実装、ナレッジ整備、運用定着へと移行している住友電装の監査AI、介入AI、レビューAI、アビームとNotionのAgent OS、TinyFishの自律Web操作AIエージェント導入の競争軸がモデル性能から業務実装、ナレッジ整備、運用定着、効果検証へ移行している #AIエージェント#機械学習#インフラ
@はたはた / 59日前 LightGBM Rankerを深掘りする:LambdaRankの仕組みと予測の中身 LightGBM RankerでLambdaRankを使うと、候補間の順位を入れ替えることでNDCGを最適化するLambdaRankはrelevanceの差に基づくΔNDCGを計算し、gain/splitで特徴量の分岐を決定する、グループ指定を誤ると順位学習が妨げられるグループ指定を誤ると別クエリのアイテムが比較対象となり、NDCG@5が4.6ポイント悪化する可能性がある #機械学習#バックエンド#DevOps・CI/CD
@Aditya Mehta / 59日前 Google DeepMind、AGIの議論を広げるインスティテュートを設立 Google DeepMindがAGIの議論を広げるインスティテュートを設立したAIの透明性の限界を克服するためのアプローチと、先端AIモデルの評価フレームワークを提案しているAI開発の安全性と規制のあり方について具体的な議論を進める必要がある #AIエージェント#生成AI・LLM#機械学習
@meijin / 59日前 Jev 所感 ダラダラと書く Jevは構造化出力に特化したAIで、LLMと協働して業務を高速化できるLLMが状態取得やテキスト化、Jevが次のアクション選択を担当、UIの動的生成にも適する単独で使うよりLLMと組み合わせたワークフローで効果的で、判断軸の言語化が必須 #AIエージェント#生成AI・LLM#機械学習
@Julie Bort / 59日前 PrismML、小さなLLMでAIの使い方を変える PrismMLが小さなLLMを開発し、PCやスマートフォンで動作させることを目指しているモデルの重みを三値化することでメモリ使用量を9〜10倍削減し、Qwen3.8 27Bを5.9GBに圧縮したモデルのサイズが小さくなることで、プライバシーが保たれ、クラウドに依存しなくなる可能性がある #生成AI・LLM#AIエージェント#機械学習
@Lucas Ropek / 59日前 AIの安全議論は安全かコントロールか AI安全の議論は安全そのものよりもコントロールを目的としている企業と政府の国際協力、自主的な規制の必要性、政府の関与の有無企業の自主的な取り組みが市場の成功に結びつくとされるが、規制の枠組みが競争に与える影響が懸念されている #AIエージェント#生成AI・LLM#機械学習
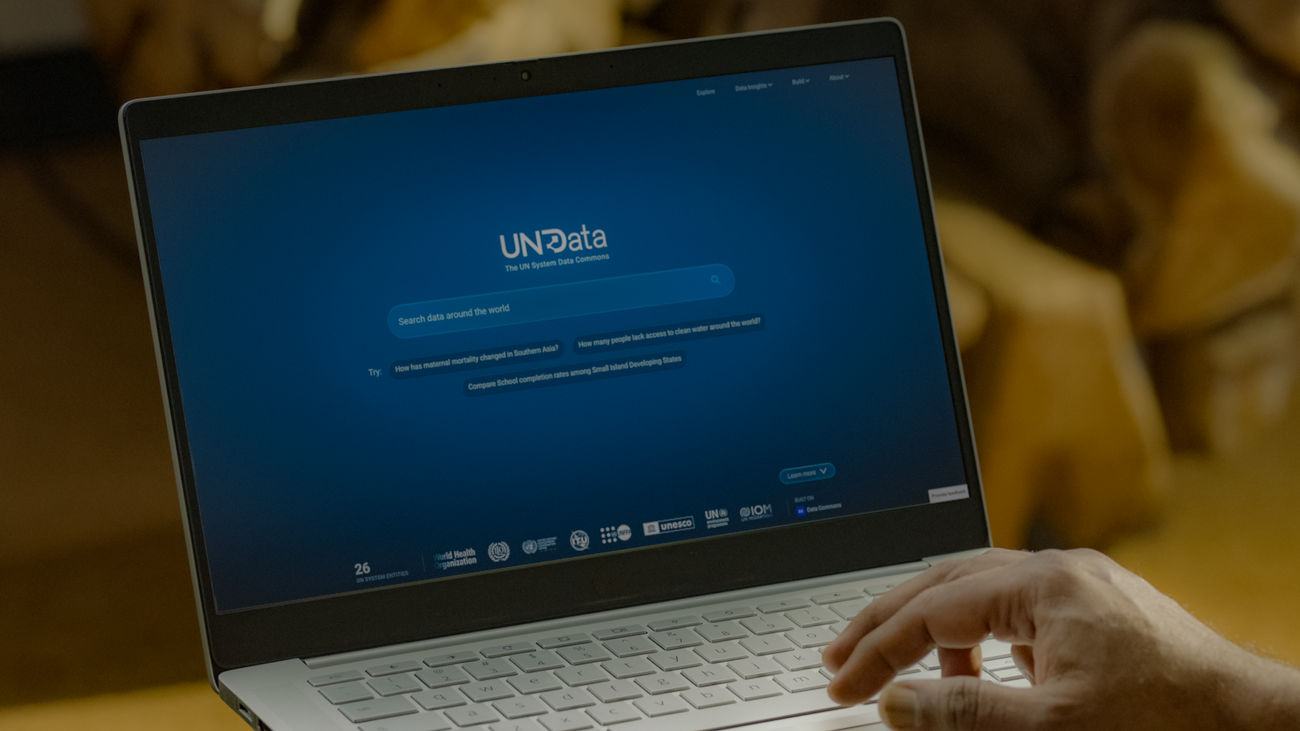
@Prem Ramaswami / 59日前 グローバルデータをより簡単に探索する UNシステムデータコモンズが公開され、グローバルデータを統合したAI対応知識グラフを提供データコモンズプラットフォームと自然言語検索機能、AIアシスタントによる分析支援データ分析にかかる手間が減り、リアルタイムでのグローバル進捗確認が可能になる #AIエージェント#生成AI・LLM#機械学習
@Rebecca Bellan / 59日前 マイクロソフト幹部がAIスクラビングを「人類最大の労働の盗難」と認めた、新たな未編集文書が明らかに マイクロソフトの幹部がAIスクラビングを「人類最大の労働の盗難」と認めたスクラビングで収集したデータに著作権情報を削除し、ペイウォールを回避して大量に取得したAIモデルのトレーニングに著作権のあるデータを使う行為が法的に問題になる可能性がある #生成AI・LLM#AIエージェント#機械学習
@Dominic-Madori Davis / 59日前 イギリスのチャールズ国王、AIの規制と倫理についての会議を開催 イギリスのチャールズ国王がAIの規制と倫理についての会議を開催したAIの急速な発展とそのリスク、国際協力の必要性が議論されたAIの開発は技術の進歩だけでなく、社会への影響も考慮する必要があることが示された #AIエージェント#生成AI・LLM#機械学習
@hisashi-ito / 59日前 Jev(TypeSafe AI)はみんなどうやって使っているのか? Jevは選択・段階評価・真偽の3種類の質問に対応し、文を返さずに確率と信頼度を返す判断モデル選択(Choice)、段階評価(Score)、真偽(Noul)の3種類の質問、入力トークンのみの料金体系日本からの利用では300ミリ秒前後の応答時間で、1秒に何度も呼び出す設計は避けるべき #生成AI・LLM#AIエージェント#機械学習
 最終更新 2026/11/16 13:01