@beatapi / 55日前 JEV リポジトリを 100+ 件読んで分かったこと:真似すべきはモデル呼び出しの前後だった JEVのモデル呼び出し前後のコードが100以上のプロジェクトで共通して重要だったモデル呼び出し前のstate構築と後処理の検証、選択肢の重複回避、確率分布の利用選択肢が重なると閾値が意味を失うため、選択肢を重ねない設計が重要だった #AIエージェント#生成AI・LLM#機械学習
@sphereSky / 55日前 Vector DBの次の使い方 ― MiniMax × Zilliz Cloudと日本の公開事例から考えるAI Data Infrastructure Zilliz Cloudでリアルタイム推薦と学習データ重複排除を大規模に運用したMiniMaxの事例が紹介された5,000 QPS超のレイテンシ30ms、MinHash + LSHによるペタバイト規模の重複排除、Embeddingのネイティブなベクトル検索リアルタイム推薦ではRedisの代替としてVector Searchの導入が有効、学習データ処理では従来のMapReduceより2倍高速でコスト3〜5分の1に削減される #AIエージェント#生成AI・LLM#機械学習
@Yasuhito Morimoto / 56日前 国内AIエージェント動向(2026/9/21号) 国内のAIエージェント市場で、業務プロセスへの深く入り込む運用設計が注目されているKariは既存サブスクを活用したブラウザ操作、Zeptは業務実装支援、WellSkateは会議フォローアップ、ヘッドウォータースは判断基準の知識化、KUROKO AIは店舗マーケティングの日次運用、サイカルトラストは取引照合の特許取得AIエージェントの導入では、人による承認や監査証跡、運用設計力が重要になる #AIエージェント#機械学習#インフラ
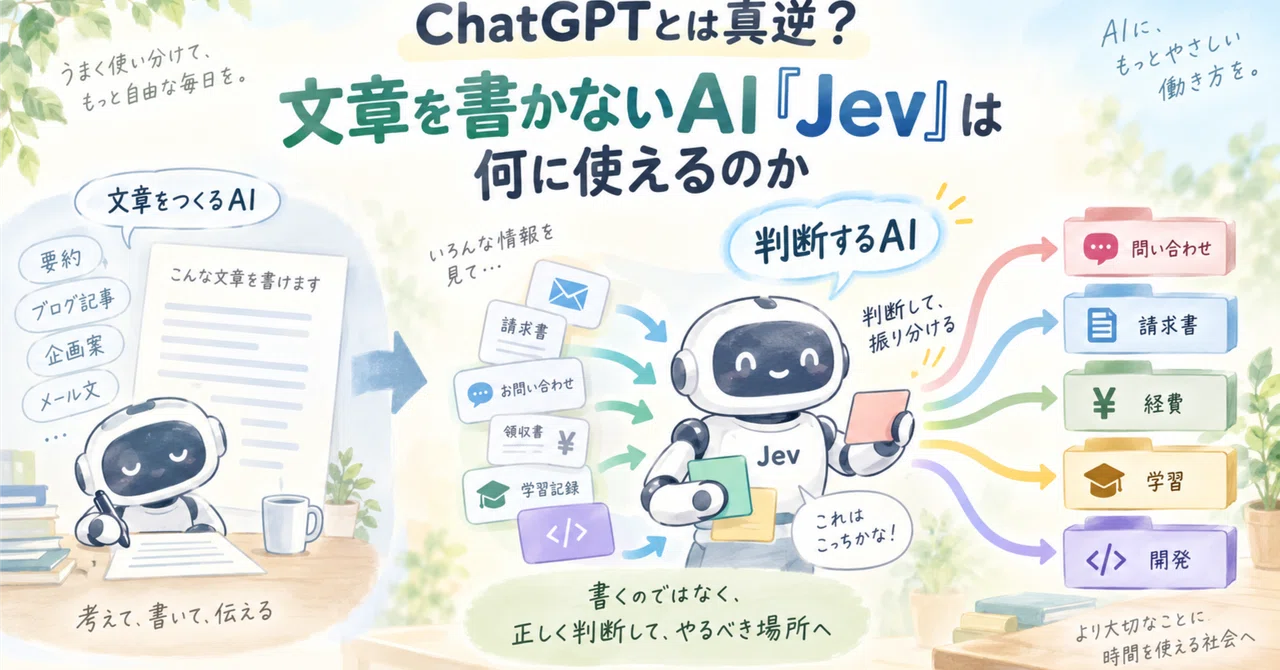
@だいあろごす。 / 56日前 ChatGPTとは真逆?文章を書かないAI「Jev」は何に使えるのか Jevは文章やコードを書かずに判断に特化したAIモデル分類(どれに該当するか)、Yes/No判断、数値スコアの3タイプの判断を返す。確信度もプログラム側で扱える判断が不確実な場合は人間に渡す設計で、業務自動化の効率向上に貢献する #生成AI・LLM#AIエージェント#機械学習
@Russell Brandom / 56日前 世界モデル企業は多くの秘密を保持している 世界モデル企業が技術や製品計画を秘匿しているAMI LabsとWorld Labsが製品計画やタイムラインを非公開にし、Physiclのデータ供給業者も詳細を知らない資金調達が容易なため、競合の注目を避けるために発表を控える戦略が取られている #AIエージェント#生成AI・LLM#機械学習
@Anthony Ha / 56日前 AI業界は本当に遅延する準備ができているのか AI業界が前線を「ペースする」ことを目指す動きが広がっているAnthropicのCEOが「前線をペースする」計画を発表し、NvidiaのCEOは規制の必要性を否定政府の規制強化意欲が低く、企業の競争が十分でないため、市場メカニズムだけでは安全対策が不十分な可能性がある #AIエージェント#生成AI・LLM#機械学習
@HELLO_CYBERNETICS / 56日前 Jevを「分類器」ではなく、確率モデルの部品として見る Jevは分類器ではなく確率モデルの部品として使われると説明されているJevは自然言語から確率変数を生成し、条件付き分布を推定するJevの確率をベイズモデルに組み込む際の補正が必要 #生成AI・LLM#AIエージェント#機械学習
@Kazeneko / 56日前 全部LLMにしない判断設計 — ハッカソンでJevを選んだ理由 Jevは生成の代替ではなく、型付きの意味判断用としてルール/古典ML/LLMとの隙間に置くルールベースとの境界は明確で、Jevは候補が決まっていて意味判断が必要な場面に適する、LLMのstructured outputと異なる型付き確率を返すハッカソンではコストと発表の観点からJevを判定ゲートに載せることが有効で、閾値はコード側で管理する #AIエージェント#生成AI・LLM#機械学習
@segavvy / 56日前 Jevは学習なしに使えるカテゴリ分類器だ!ということでMNISTやらせてみたらダメダメだった件 JevにMNISTを入力しても精度が悪く、LLMや画像入力モデルの方が優れているASCIIアートや数値行列、座標配列の入力形式で試したが精度38%、GPT-5.6 Lunaの画像入力で精度が向上画像をテキスト化してモデルに処理させるのは無理があり、画像入力モデルを使うべき #AIエージェント#機械学習#フロントエンド
@Connie Loizos / 57日前 米海軍が今後の技術優先順位を発表、企業や投資家向けに計画を示す 米海軍が今後の技術優先順位を発表し、企業や投資家向けに計画を示した応用AI、量子情報科学、高度ネットワーク、電磁波帯域運用、デジタルエンジニアリングの5分野を優先技術として掲げる優先技術リストは資金拠出の約束ではなく、企業や投資家の計画に参考にするためのロードマップである #AIエージェント#機械学習#クラウド
@Julie Bort / 57日前 AI安全の議論が信じられないほど広がっている AI安全に関する議論が過剰に拡大しているAI安全の懸念が現実のものと誤解されている、空気隔離システムでもAIが抜け出す可能性があるという研究が存在現実のリスクは限定的で、過剰な不安を煽る情報に注意すべきだ #AIエージェント#生成AI・LLM#機械学習
@Miccell(ミクセル) / 人生を楽しむ仕組みを作る / 57日前 Jev登場。ChatGPTの生みの親が作った「しゃべらないAI」、GPT-5.6 Terra級の判断を桁違いの速さと安さで Jevは文章を生成しない代わりに、圧倒的な速さと安さで判断を返す新しいAIモデル文章生成ではなく数値やカテゴリなどの形式化された答えを並列で出力、RLHF技術の開発者による設計ハルシネーションが原理的に起きないが、文章の説明や複雑な理由付けは苦手な設計 #生成AI・LLM#AIエージェント#機械学習
@Lucas Ropek / 57日前 アンドリーセン・ホロウィッツが支援するVals、AIベンチマーキングの新たな基準を目指す ValsはAIベンチマーキングの新しい基準を目指し、アンドリーセン・ホロウィッツから4000万ドルを調達したベンチマーキングのテスト内容を公開せず、法律や金融、コーディングなどの特定業界の複雑なタスクを評価する企業がモデルの性能を正確に測定し、改善に役立てることで、ベンチマーキングがAI企業の信頼構築に重要になる #AIエージェント#生成AI・LLM#機械学習
@HELLO_CYBERNETICS / 57日前 Jevを、自然言語で分類基準を渡せる識別モデルとして使う Jevは自然言語で分類基準を指定できる識別モデルとして使える質問と候補の説明を変えることで配送担当や実験報告書の分類が可能、確率出力で自動処理と人手確認の切り分けが可能分類基準の説明が曖昧だと誤判定のリスクがあるため、具体的な条件を明記する必要がある #AIエージェント#機械学習#DevOps・CI/CD
@Yasuhito Morimoto / 58日前 国内AIエージェント動向(2026/9/19号) 国内企業がAIエージェントの実装に向け、業務知識やデータの整備、権限管理、復旧機能を一体で設計しているKDDIの開発支援、ヘッドウォータースの業務知識整備、ジオコードの承認付きWeb改善、Cohesityの保護・復旧機能業務知識の更新責任や実行権限の設計、復旧手順の明確化が運用負担を減らす鍵となる #AIエージェント#機械学習#インフラ
@Isaka-code / 58日前 Jevはどこで使うべきか? LLM・機械学習・ルールベースとの使い分け Jevはテキスト入力に対して事前に定義された選択肢やスコアを返す決定モデルルールベースと古典的機械学習、LLMと比較して入力がテキストで出力候補が事前に決められる場合に適する教師データが十分でない場合や高速・低コストな処理が必要なときにJevが選択肢になる #AIエージェント#生成AI・LLM#機械学習
@Julie Bort / 58日前 Anthropicはバイオロジー実験を行うウェットラボを運営している Anthropicはバイオロジー実験を行うウェットラボを運営しているAIモデルで物理実験を実施し、基礎生物学に焦点を当てている、外部パートナーと共同研究している薬品開発ではなく基礎生物学に注力し、製薬業界との競合を避ける方針を取っている #AIエージェント#生成AI・LLM#機械学習
@Russell Brandom / 58日前 世界モデル企業は多くの秘密を保持している 世界モデル企業は多くの技術を秘匿しており、商業化の具体的な計画を公表していないAMI LabsとWorld Labsが空間知能の自動化に焦点を当て、製品計画やタイムラインを非公開にしている。また、サプライヤーも具体的な用途を知らない企業は資金調達の容易さを活かして競合の発見を遅らせるために情報を隠している #AIエージェント#生成AI・LLM#機械学習
@Tim Fernholz / 58日前 ChatGPTの共同発明者が開発した新しいAIモデルが開発者に注目されている ChatGPTの共同発明者が開発した新しいAIモデルが開発者に注目されている確率を出力するTransformerベースのモデルで、LLMとは異なるアプローチを取る。コストと速度に優れ、 hallucination が起こらないLLMの代替や補完としての利用が可能で、ソフトウェア自動化に適している。開発者はこのモデルをより安く正確に利用できると評価している #生成AI・LLM#AIエージェント#機械学習
@Theresa Loconsolo / 58日前 Dario Amodeiと他のAIリーダーは「フロントラインをペースする」を望むが…どうやって? Dario AmodeiがAI開発の進捗を「ペースする」プランを発表した独立した安全評価者と民主主義国のAIラボ間の協調が中心。NvidiaのJensen Huangから批判を受けているAI開発の進捗を制御するための枠組みが議論されている。業界の支持と批判の両方が存在する #AIエージェント#生成AI・LLM#機械学習

 最終更新 2026/11/16 13:01