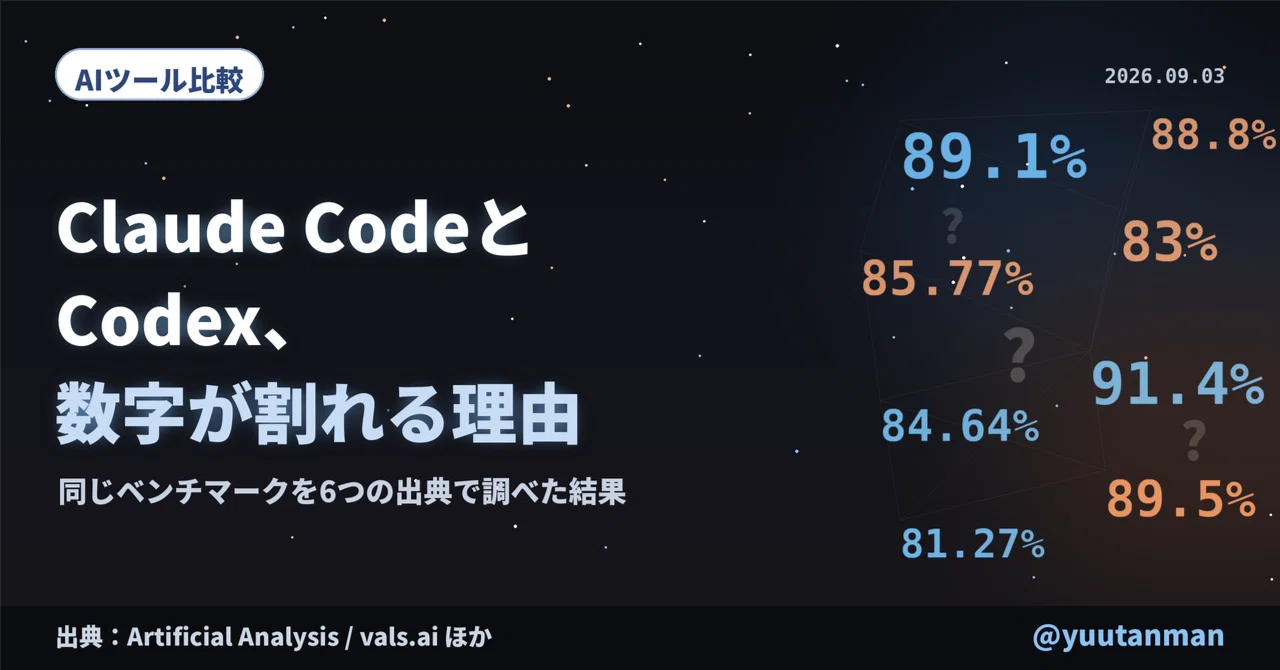
@東京PCレスキュー隊長 / 74日前 Claude CodeとCodex、数字が割れる理由 Terminal-Bench 2.1の結果が6つの出典で異なる理由が明らかに推論エフォート設定、ハーネスの違い、拒否時のフォールバック処理、測定時点が主な要因ベンチマークの数値は設定や測定条件によって大きく変わるため、どの条件で測ったかを確認する必要がある #生成AI・LLM#AIエージェント#機械学習
@Miccell(ミクセル) / 人生を楽しむ仕組みを作る / 74日前 Claude Fable 5.1が登場。性能は科学分野で2倍超、価格は実質最大45%減 Claude Fable 5.1が発表され、科学分野のベンチマークスコアが2倍以上に向上Terminal-Bench-Science 0.1で24.7%から52.6%、キャッシュ読み込み単価が75%低下キャッシュ読み込みコストが75%削減され、エージェント用途では最大45%の実質価格低下が発生 #生成AI・LLM#AIエージェント#機械学習
@xthixsl_ml@レオナ / 74日前 Kaggle Pokémon TCG AI Battle Challenge ポケカコンペ振り返りーメダルなし ポケモンカードゲームのAIエージェント開発で、強化学習と模倣学習を組み合わせた手法を試した模倣学習(Behavior Cloning)で上位エージェントの行動を学び、PPOによる強化学習で補正。価値関数で数ターン先の勝率を予測し、相手デッキを推定する仕組みを導入価値関数のAUCが0.934でも実際の勝率改善は1.1ポイントにとどまり、モデル単体の指標だけでは採用判断できないことが分かった #AIエージェント#機械学習#DevOps・CI/CD
@小川幹雄 / 74日前 AIエージェント時代にデータサイエンティストは生き残れるのか データサイエンティストの職種は中身を総取り替えされ、AIエージェント時代に生き残るためには数学的・ソフトウェア工学的スキルが必須になるAIコーディングで定石をなぞる仕事が自動化され、数学的知識とソフトウェアエンジニアリングスキルが価値を生む。協会のスキルチェックリストで価値創造力と融合スキル群が新設データサイエンティストとしての価値は数学的・ソフトウェア工学的スキルの両輪に依存し、中途半端な知識では競争力を維持できない #AIエージェント#機械学習#データ分析
@Yasuhito Morimoto / 75日前 国内AIエージェント動向(2026/9/2号) 国内AIエージェントが業務の実行・継続監視・システム反映へと適用範囲を広げたSFA・CDP・業務システムとの接続、MCP標準連携、人による承認と最終確認、導入後の定着支援が共通点β版やPoCを含む段階的な提供が多く、権限管理、監査性、例外処理、定量KPIの開示が普及の焦点になる #AIエージェント#機械学習#クラウド
@たこやき / 75日前 表記ゆれで埋め込みベクトルの類似度はどれだけ変動するのか 【Amazon Titan Embeddings V2】 AWS Bedrockのamazon.titan-embed-text-v2:0で表記ゆれの類似度を検証したアルファベット大小・区切りゆれ、文字種の違い、現場でよく見る表記ゆれ、タイポ・記号ゆれの4カテゴリでcos類似度を計算カタカナや英字の違いで類似度が0.048〜0.088と大きく低下し、空白や記号のゆれはタイポより検索に影響大 #生成AI・LLM#RAG#機械学習
@maskot1977 / 75日前 耳で聞く!Python で学ぶ マクロ経済学 入門 7 Pythonでゼロ金利政策の経済モデルをシミュレーションし、財政政策の効果を可視化したISLMモデルとZLB(ゼロ金利制約)を用いて金利と国民所得の関係を数値解析、財政乗数の変化を確認ゼロ金利下では政府支出の効果が顕著に上がり、クラウディングアウトが発生しないことが実証された #機械学習#バックエンド#クラウド
@しんや / 75日前 What's New in Sigma - 2026年08月28日のSigma Computing関連リリース情報まとめ Sigma Assistantが全データソースを検索できるようになったAll sourcesモードでユーザーがアクセス権を持つ全ソースを対象に、Specific sourcesで管理者が登録したソースのみを対象に選択可能All sources選択時はデータアクセス権を尊重し、データモデル整備が回答精度に影響するため整備のROI向上が期待できる #AIエージェント#生成AI・LLM#機械学習
@林 宏正 / 75日前 Weekly Google Cloud アップデート情報 - 2026年9月1日 Google CloudでGemini EnterpriseのデータストアとAI開発者ツールがリリースされたD&B Commercial GraphデータストアとCloud Monitoring可観測性のメトリクス拡張、Gemini Enterprise Agent PlatformにxAIs Grok 4.6とGLM 5.2が追加されたAI開発者ツールの利用にはCloud Billingアカウントのリンクが必要で、エマージングマーケット版は限定的な利用条件がある #クラウド#AIエージェント#機械学習
@y.takayama / 75日前 【Nishika 論文サク読み 第24回】DiaScriber DiaScriberは話者ダイアライゼーションと文字起こしを1モデルで行うMSASRモデルQwen3-ASR由来の音声エンコーダとQwen3.5-Omniの23B MoEを組み合わせ、85,000時間の学習データを使用公開5セットでは3セットでMOSSに負けていることが判明し、モデルサイズだけでは性能が確保できないことが示されている #生成AI・LLM#機械学習#AIエージェント
@monokaai / 76日前 AI開発でいつ、どこまでコードを理解するか AI開発では影響度と戻しやすさを基準にコードの理解度を調整する失敗時の影響が大きい・戻しにくい変更は重点確認、テストで決定論的に制御可能なら後回し可能テストケースの整備で実装者の仕様理解を確保し、行レベルの理解は後回しにできる #AIエージェント#機械学習#DevOps・CI/CD
@t.toda / 76日前 無音で文字起こしすると「ご視聴ありがとうございました」になる理由を検証 Whisperは無音時に「ご視聴ありがとうございました」と出力する訓練データの感謝フレーズに引き込まれる、デコーダLMの高頻度系列が原因no_speech_probとavg_logprobの条件で抑制が効かないため、パラメータ調整では対応できない #生成AI・LLM#AIエージェント#機械学習
@暮らしと心のアプリ工房(ワンコインWEBアプリ屋さん) / 76日前 AIを見るな、人を見ろ ※追記:この記事をClaudeに読ませてみたら(号泣) AIのベンチマーク競争に振り回されず、開発企業の思想や哲学を見ることでツール選びの迷いが解消されるAIの人格は創業者の哲学と歴史でできている、AIの性能は技術者が決めるが何を出荷するかは経営が決めるAIの性能を評価する際には、技術的な要素だけでなく経営の判断も考慮する必要がある #AIエージェント#生成AI・LLM#機械学習
@harrowharrow16 / 76日前 IBM Bobを使って、量子コンピュータで量子機械学習(QSVM)を作成してみる。 IBM Quantum Platformで量子SVMを実装し、Irisデータで分類精度0.90を達成したZZFeatureMapによる量子特徴マップとシミュレーター/実機でのカーネル計算、reps=1のパラメータが精度向上に寄与実機ではノイズの影響で精度が低下するが、浅い回路構造でその影響を抑えることが可能で、量子カーネルの現状の性能が確認できる #AIエージェント#機械学習#インフラ
@週末ものづくり部 / 76日前 トークン2000分の1——オントロジー×ナレッジグラフでClaude Codeの推測を消す Claude Codeにナレッジグラフを導入してトークン使用量を2000分の1に削減code-review-graphとbetter-code-review-graphによる依存関係グラフ、Graphifyによる横断的ナレッジグラフ、SerenaによるLSP型情報検索トークン使用量が14万から70に安定して減少し、ファイルを開かずに構造を把握できる #AIエージェント#RAG#機械学習
@kei / 76日前 第3話「世界の中心で VRAM16GB は足りないと叫ぶ!」 追加GPU選び / ローカルLLMマシン構築記【実録】 VRAM16GBでは30B級モデルを扱えず、4人の要因がVRAM消費を増やすモデルサイズと量子化、コンテキスト長、同時実行数、エージェントの並行稼働数がVRAMを圧迫するVRAM容量を決める際にはモデルサイズ・コンテキスト長・同時実行数・エージェントの並行稼働数を事前に優先順位づける必要がある #生成AI・LLM#AIエージェント#機械学習
@Yutaka Kashiwabara / 76日前 AgentCore Memoryのflexible namespace variablesを実測 — 渡し忘れをNull条件で即時エラー化 AWS Bedrock AgentCore Memoryにflexible namespace variablesが追加され、カスタム変数をnamespaceテンプレートに反映できるようになったnamespaceKeysでカスタムキーを宣言し、namespaceTemplatesでテンプレートを定義し、CreateEventで実行時の値を渡す。組み込み変数とカスタムキーの両方をサポート変数を渡さない場合、長期記憶が作られないが成功レスポンスが返るため、IAMのNull条件で存在チェックを強制する必要がある #AIエージェント#機械学習#クラウド
@YOJO Technologies Blog / 77日前 AI時代に必須の考え方「評価駆動開発」とは何か 評価駆動開発はLLMアプリケーションの改善と運用のための新しい開発手法評価指標の設計とLLM-as-a-Judgeによる評価、実践的なツールの使い方が解説されている評価の基準を明確にしないとAIの成果を最大限に引き出せないことが強調されている #AIエージェント#生成AI・LLM#機械学習
@tomohisa / 77日前 128GB の Mac で Qwen3.8 Flash Next をどう動かすか ─ 3つのランタイムを実測で比べた Qwen3.8 Flash Next を 128GB の Mac で動かす 3 つのランタイムを実測で比較したllama.cpp はデコードが遅いが実務で完走、mlx-serve はプレフィルとデコードが最も速い、oMLX はキャッシュ処理でエージェントループで壊れるmlx-serve は 105GB のモデルが必要でメモリ制限を回避するオプションが必要、llama.cpp は実務で安定して完走するがデコードが遅い #生成AI・LLM#AIエージェント#機械学習
@nolanlover0527 / 77日前 LLMが「1+1」を計算するとき、中で何が起きているのか LLMは数字をトークンとして処理し、複数の経路で近似と精密計算を組み合わせて答えを出すトークン化された入力は埋め込みベクトルに変換され、アテンションで関係性を計算。36+59では大まかな見積もりと下1桁の精密計算の2経路が使われる正確な計算が必要な場面ではLLM単体ではなく計算ツールを併用するべきで、モデル自身の説明と実際の計算過程が一致しない可能性がある。 #生成AI・LLM#機械学習#AIエージェント
 最終更新 2026/11/16 14:01